Agent de développement d’OpenAI qui explore un dépôt, modifie les fichiers, exécute les commandes et les tests, puis relit ses propres changements. Il fonctionne dans le terminal (CLI open source en Rust), les IDE, l’application de bureau ChatGPT et le cloud, et s’étend par
AGENTS.md, skills, plugins, serveurs MCP, hooks et sous-agents.
Composition : skills système (skill-creator, skill-installer…), catalogue openai/skills, skills personnelles, de projet et de plugins ; 3 agents intégrés (default, worker, explorer), plus les agents personnalisés ; outils MCP selon les serveurs connectés (stdio, HTTP streamable).
Voir aussi : la section Avis indépendants pour une synthèse des retours et opinions publiés, et OpenAI Codex mémo pour les commandes et raccourcis.
Résumé
Codex est l’agent harness d’OpenAI pour le développement logiciel. Il entoure les modèles GPT d’une boucle agentique qui lit le code, planifie, édite plusieurs fichiers, lance des commandes dans un bac à sable, vérifie le résultat et peut relire le diff avant de rendre la main. On lui confie une tâche complète : corriger un bug, écrire des tests, migrer un module, préparer une PR ou analyser un codebase inconnu.
Le produit s’est construit par couches. La CLI open source est sortie le 16 avril 2025, suivie un mois plus tard de Codex Cloud, où chaque tâche s’exécute dans un conteneur isolé préchargé avec le dépôt. L’application de bureau est arrivée en février 2026 pour superviser plusieurs agents en parallèle. Depuis le 9 juillet 2026, elle est fusionnée dans l’application de bureau ChatGPT, qui regroupe trois modes : Chat, Work et Codex. Toutes ces surfaces reposent sur un même « App Server » qui partage les sessions, les approbations et la configuration entre la CLI, l’extension VS Code, le web, le bureau et des intégrations tierces comme JetBrains ou Xcode.
Depuis le 22 septembre 2026, le modèle par défaut est GPT-6 Sol, affiché à moitié prix de la génération GPT-5.6. GPT-6 Luna couvre les tâches rapides et volumineuses, GPT-6 Astra les travaux les plus exigeants. Le niveau de raisonnement va de low à max, et le mode ultra répartit le travail entre des sous-agents. La CLI peut aussi utiliser un modèle local via LM Studio ou Ollama (--oss), mais l’outil reste conçu autour des modèles d’OpenAI.
La sécurité repose sur un sandbox imposé par le système d’exploitation (Seatbelt sur macOS, Landlock et seccomp sur Linux, sandbox natif sous Windows), combiné à une politique d’approbation. Par défaut, l’agent écrit uniquement dans le dossier de travail et n’a pas accès au réseau. Les règles execpolicy, un proxy réseau à liste blanche de domaines et une revue automatique des demandes d’approbation affinent ce cadre.
Codex est inclus dans tous les forfaits ChatGPT, avec des quotas croissants. Le forfait gratuit donne accès à GPT-6 Luna dans l’application de bureau. Viennent ensuite Go (8 /mois), Plus (20 /mois), Pro (à partir de 100 /mois, pour 5 ou 20 fois les limites de Plus), Business (20 par utilisateur et par mois en annuel), Enterprise et Edu. Des crédits supplémentaires peuvent être achetés, et une clé d’API permet une facturation au token pour la CI. Le dépôt openai/codex contient le code de la CLI sous Apache-2.0. L’application de bureau et les services cloud restent propriétaires, et le projet n’accepte pas les pull requests externes. OpenAI revendiquait plus de 2 millions d’utilisateurs hebdomadaires en mars 2026. La version stable v0.157.0 est sortie le 25 septembre 2026.
Fonctionnalités
-
Boucle agentique complète : exploration du dépôt, édition multi-fichiers via un outil de patch, exécution de commandes et de tests, gestion de git et vérification des résultats.
-
Surfaces multiples : CLI/TUI, extension VS Code (compatible Cursor et Windsurf), mode Codex de l’application de bureau ChatGPT (macOS, Windows), web et cloud sur chatgpt.com/codex, pilotage à distance (
codex remote-control) et intégration à GitHub Agent HQ. -
Instructions de projet : chaîne de fichiers
AGENTS.md, du fichier global~/.codex/AGENTS.mdà la racine du dépôt puis jusqu’au dossier courant. Chaque niveau peut avoir sonAGENTS.override.md, avec des noms de repli configurables et une limite de 32 Kio par défaut. -
Skills : workflows au format ouvert
SKILL.md, chargés progressivement (la liste initiale occupe au plus 2 % du contexte). Codex les cherche dans.agents/skills(dossier courant, dossiers parents, racine du dépôt),~/.agents/skillset/etc/codex/skills. On les appelle avec$nomou/skills. Les skills système$skill-creatoret$skill-installercréent ou installent de nouvelles skills. -
Plugins et marketplaces : paquets regroupant skills, connecteurs d’applications et configuration MCP, installés avec
codex plugin adddepuis des marketplaces Git ou locales. Les administrateurs peuvent autoriser ou bloquer des plugins et publier des marketplaces privées. -
MCP :
codex mcp addenregistre des serveurs locaux (stdio) ou distants (HTTP streamable), avec authentification OAuth et jetons tirés de variables d’environnement. -
Sous-agents et agents personnalisés : délégation en parallèle sur demande explicite (« un agent par point »), consultation des fils avec
/agent, agents intégrésdefault,workeretexplorer. On définit ses propres agents dans~/.codex/agents/ou.codex/agents/(modèle, effort de raisonnement, sandbox, serveurs MCP et skills par agent). -
Mode plan et objectifs :
/planfait proposer un plan avant toute modification./goalfixe un objectif persistant que Codex poursuit sur une longue durée, avec pause, reprise et édition. -
Revue de code :
/review(branche de base, changements non commités, commit ou consignes libres) sans toucher au working tree.codex reviewfait la même chose en non interactif. Dans GitHub,@codex reviewpublie une revue limitée aux problèmes P0 et P1, avec revues automatiques en option et règles## Code Review RulesdansAGENTS.md. Une Security Review plus poussée est disponible en research preview. -
Automatisation et CI :
codex execavec sortie JSONL, validation de la réponse finale par schéma JSON (--output-schema), reprise de session, SDK, et tâches planifiées dans l’application de bureau. -
Codex Cloud :
codex cloud execenvoie une tâche dans un environnement distant, avec jusqu’à 4 tentatives en parallèle (best-of-N).codex applyrapatrie le diff dans le dépôt local. -
Sessions et travail parallèle : reprise (
codex resume), fork (codex fork,/fork), discussions annexes (/side), exécution dans un git worktree (/worktreedans l’application), terminaux d’arrière-plan (/ps,/stop). -
Hooks : scripts ou outils MCP déclenchés à 12 moments du cycle de vie (
SessionStart,PreToolUse,PermissionRequest,PostToolUse,PreCompact,Stop…). Tout hook non géré doit être relu et approuvé avant de s’exécuter. -
Sandbox, approbations et réseau : modes
read-only,workspace-writeetdanger-full-access; politiqueson-requestounever; profils de permissions nommés ; règlesexecpolicy; proxy réseau avec liste blanche de domaines et protection contre le DNS rebinding. -
Outils intégrés : recherche web (index en cache par défaut,
--searchpour le direct), images en entrée, génération d’images, voix, mémoires (expérimental), navigateur et computer use dans l’application de bureau. -
Migration :
/importrécupère la configuration, les projets et les conversations de Claude Code ou de Cursor.
Analyse
| Critère | Note |
|---|---|
| Documentation | ★★★★★ |
| Précision des descriptions | ★★★★☆ |
| Maturité | ★★★★☆ |
| Popularité | ★★★★★ |
Notes Documentation, Précision et Maturité alignées sur le barème global (10 octobre 2026). Popularité calculée depuis les étoiles du dépôt GitHub : 135 486 au 16 novembre 2026.
Points forts
-
Continuum local → cloud → bureau : la même configuration (
config.toml,AGENTS.md, skills, MCP) sert partout. Une tâche peut démarrer dans le terminal, partir dans le cloud puis revenir sous forme de diff aveccodex apply. -
Sandbox au niveau du système d’exploitation : l’isolation ne dépend pas seulement d’un classifieur. Seatbelt, Landlock ou le sandbox Windows limitent réellement les écritures et le réseau, et
codex sandboxpermet de tester une commande sous la même politique. -
Pensé pour l’automatisation : chaque fonction existe en sous-commande scriptable (
exec,review,cloud,apply,mcp,plugin), avec sorties JSON, schéma de réponse et codes de retour exploitables en CI. -
Standards ouverts :
AGENTS.md, Agent Skills et MCP sont natifs, si bien que la plupart des écosystèmes de skills conçus pour Claude Code fonctionnent aussi dans Codex (Superpowers, GStack, Humanizer…). -
Rapport coût/usage apprécié : GPT-6 Sol est affiché à moitié prix de GPT-5.6, soit environ 2
/10par million de tokens en entrée/sortie selon les comparatifs publiés. Plusieurs comparatifs de 2026 relèvent une consommation de tokens inférieure à celle de Claude Code pour une même tâche, mais il s’agit de mesures ponctuelles de tiers (souvent de seconde main) dont l’écart varie de 1,4 à 4 fois ; l’avantage pèse surtout en API et en CI, et il est en partie annulé par les coupures de quota en cours de fenêtre (voir Limites). Le forfait gratuit et le forfait Go à 8 $ abaissent aussi le coût d’entrée. -
Documentation de référence exhaustive : chaque commande, option et clé de configuration est décrite avec son niveau de maturité (Experimental, Beta, Stable, Deprecated).
-
Développement très actif et code auditable : CLI Apache-2.0 en Rust et plusieurs préversions par jour en septembre 2026.
Limites
-
Écosystème centré sur OpenAI : les modèles locaux sont possibles avec
--oss, mais les fonctions avancées (cloud, revue GitHub, application de bureau, mémoire) supposent un compte ChatGPT ou OpenAI. Un harness multi-fournisseurs comme OpenCode laisse plus de liberté. -
Quotas difficiles à anticiper : les limites fonctionnent par fenêtres de 5 heures et plafonds hebdomadaires. Elles varient selon le modèle, l’effort de raisonnement et la taille du contexte (surcoût au-delà de 272k tokens). Les modes
xhigh,maxouultraépuisent vite un forfait, et des utilisateurs ont signalé des baisses de quota non annoncées en août 2026. -
Surface d’attaque réelle : une injection de commande via un nom de branche GitHub permettait de voler des jetons d’accès (signalée fin 2025, corrigée puis rendue publique en mars 2026). Deux évasions de sandbox (« Heapjack » dans l’application, « Overpatch » dans la CLI) ont été signalées le 12 août 2026 et corrigées le 20 août (CLI 0.149.0). Il faut maintenir l’outil à jour.
-
Produit en mouvement permanent : fusion dans l’application ChatGPT avec des régressions à la transition (
codex appqui ne retrouvait plus l’application, par exemple), documentation déplacée de developers.openai.com vers learn.chatgpt.com et politique d’approbationuntrustedretirée. Une configuration peut cesser de fonctionner d’une version à l’autre. -
Open source, mais pas communautaire : les contributions de code externes sont refusées et le dépôt dépasse 18 000 issues et PR ouvertes. L’application de bureau et les services cloud ne sont pas ouverts.
-
Complexité croissante : sous-commandes, feature flags, profils, permissions, hooks, plugins, marketplaces et modes de l’application forment une surface de configuration lourde. Les fonctions dépendent aussi du forfait, de la plateforme et du déploiement progressif.
-
Comportement dépendant du modèle : les modèles récents peuvent sur-construire, par exemple en ajoutant une infrastructure de tests non demandée, ou s’écarter d’un plan précis. Un témoignage détaillé évoque même des écarts à des consignes claires lors d’opérations git destructrices, avec un risque de perte de données : plan validé, commits fréquents et contrôle humain restent nécessaires. Le résultat varie sensiblement avec le modèle et l’effort choisis.
Qualité
Commentaire : la documentation est l’une des plus complètes du marché : chaque option est référencée avec sa maturité, et les exemples sont nombreux. La précision des descriptions perd une étoile. La description du dépôt (« agent léger dans le terminal ») sous-estime le produit, le README pointe encore vers l’ancienne documentation, et beaucoup de fonctions ne sont disponibles que selon le forfait ou la plateforme. La maturité est élevée : CLI stable, large adoption, contrôles d’entreprise, sandbox natif. Elle reste tempérée par le rythme des changements, la transition heurtée vers l’application ChatGPT et plusieurs failles de sécurité corrigées en 2026.
Relations
-
Alternative à : Claude Code, OpenCode, Cursor, GitHub Copilot CLI, Gemini CLI
-
Complémentaire de : Hermes Agent qui peut lui déléguer le code ; GStack, dont la skill
/codexdemande un second avis à Codex depuis Claude Code ; frameworks de skills compatibles comme Superpowers, BMAD Method, Wshobson Agents et AI Berkshire -
S’intègre avec : GitHub, VS Code, Cursor, Windsurf, JetBrains, Xcode, Figma (via MCP), Linear, Amazon Bedrock, LM Studio, Ollama, MemPalace, OpenCLI
-
Utilise : GPT-6 Sol, Luna et Astra, MCP, Skills, Subagents, Hooks, Plugins,
AGENTS.md, Rust
Mémo pratique
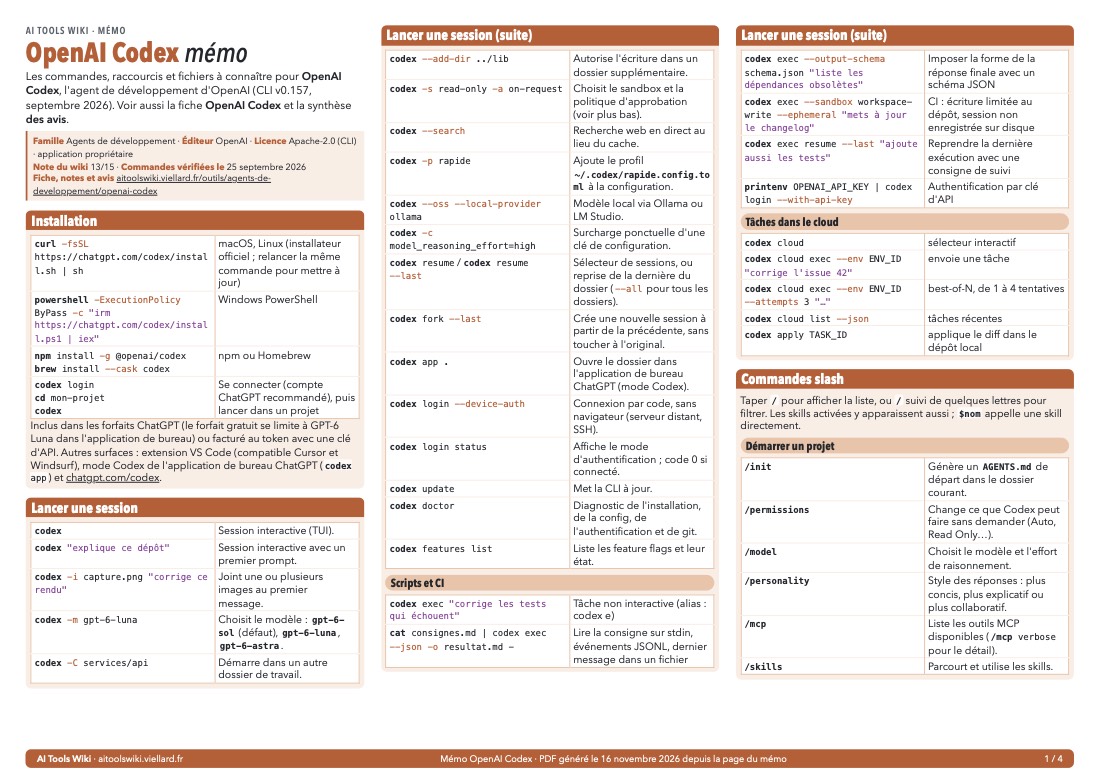
Télécharger le mémo en PDF (4 pages A4 paysage, 458 Ko). Il est généré depuis la page du mémo, qui reste la version de référence : commandes à copier, recherche dans le site.
Avis indépendants
Synthèse des tests, discussions et critiques publiques sur OpenAI Codex. Relevé le 25 septembre 2026. Voir aussi OpenAI Codex mémo.
En bref
| Aspect | Tendance des retours |
|---|---|
| Exécution de tâches bien cadrées | Très positive |
| Style du code et des réponses | Positive : concis et sobre, parfois trop peu anticipateur |
| Consommation de tokens et prix | Positive face à Claude Code |
| Quotas des forfaits | Négative : coupures en cours de tâche, baisses ressenties en août 2026 |
| Sur-ingénierie avec les derniers modèles | Négative sur les efforts xhigh, max et avec GPT-6 Astra |
| Continuum CLI, application, cloud et parallélisme | Très positive |
| Revue de code | Positive |
| Fusion dans l’application ChatGPT | Mitigée |
| Sécurité et sandbox | Bon modèle par défaut, mais plusieurs failles corrigées en 2026 |
| Recul critique disponible | Moyen : une étude académique, beaucoup de comparatifs de blogs et de témoignages |
L’opinion dominante est favorable, surtout chez les développeurs qui savent spécifier précisément ce qu’ils veulent. Codex est décrit comme un exécutant fiable : il suit la consigne, écrit moins de code superflu que ses concurrents, consomme moins de tokens et se prête bien à la délégation et à l’automatisation. Les critiques portent moins sur la qualité brute que sur l’expérience autour : quotas imprévisibles, modèles récents qui en font trop, transition heurtée vers l’application ChatGPT et failles de sandbox à surveiller.
Le débat reste dominé par la comparaison avec Claude Code. La majorité des retours ne désigne pas de vainqueur : Codex pour exécuter et relire, Claude Code pour explorer, concevoir et travailler à partir de demandes floues. Beaucoup de développeurs utilisent les deux.
Ce qui est apprécié
Un exécutant fiable pour les tâches bien spécifiées
C’est le point le plus constant. La synthèse de vexp (juin 2026), fondée sur des milliers de commentaires Reddit, retient l’image d’un outil qui livre de façon régulière à partir d’une spécification claire. Sur les 202 citations retenues, 57,4 % penchent vers Codex, surtout pour sa disponibilité en pratique. Le test de XDA Developers (juin 2026) arrive à la même conclusion : Codex excelle sur les tâches délimitées avec un critère de vérification clair (validation de formulaire, correction de bug) et se laisse déléguer sans surveillance rapprochée.
Anthony Maio (mai 2026) explique cette préférence par la fiabilité plutôt que par l’intelligence brute. Selon lui, Codex applique mieux les principes de « harness engineering » : lire avant de modifier, chercher le code existant avant d’inventer un outil, suivre le plan et respecter les conventions du dépôt. Un agent qui échoue de façon prévisible finit par inspirer plus confiance qu’un modèle brillant mais instable.
L’étude académique la plus solide va dans le même sens. Sur 7 156 pull requests réelles analysées par Pinna et al. (prépublication arXiv, révisée en mai 2026), Codex affiche des taux d’acceptation élevés et réguliers dans les neuf catégories de tâches, entre 59,6 % et 88,6 %. Aucun agent ne domine partout : Claude Code est en tête sur la documentation (92,3 %) et les nouvelles fonctionnalités (72,6 %), Cursor sur les correctifs (80,4 %). Le type de tâche pèse d’ailleurs plus lourd que le choix de l’agent : 82,1 % d’acceptation pour la documentation contre 66,1 % pour les fonctionnalités.
Un style concis et « contenu »
Lucian Ghinda, développeur Ruby on Rails, a comparé les deux outils pendant une semaine sur le même codebase (21 août 2026, GPT-5.6 Sol contre Opus 5, tous deux en xhigh). Codex écrit un code plus simple, avec moins d’abstractions et de commentaires, et fait ce qu’on lui demande sans en rajouter. Claude, à l’inverse, anticipe davantage de cas limites. Codex modifie plus vite, mais l’auteur ne constate aucun gain de temps une fois les tests et la relecture terminés.
Dans la discussion Hacker News qui a suivi (plus de 280 commentaires), plusieurs utilisateurs louent des réponses techniques et peu bavardes. Ils apprécient aussi l’absence de longs blocs de commentaires et de fichiers de planification semés dans le dépôt. Certains ajoutent que Codex perd moins d’informations lors de la compaction du contexte.
Une consommation de tokens plus sobre
Les comparatifs consultés vont dans la même direction, même si l’écart varie beaucoup et provient de mesures ponctuelles, souvent de seconde main. D’après la synthèse de Tech Insider, Firecrawl a mesuré environ 1,4 fois plus de tokens pour Claude Code sur des tâches équivalentes (juin 2026, environ 136 000 tokens contre 192 000, soit 23 % de surcoût), et Morph un écart proche de 4 fois sur son propre jeu de tests (août 2026). L’écart pèse surtout sur l’usage par API et en CI, beaucoup moins sur un abonnement utilisé en interactif. Au 22 septembre 2026, GPT-6 Sol est affiché à environ 2 /10 par million de tokens, contre 4 /20 pour Claude Opus 5.5, selon le comparatif de CatDoes. Sur le forum officiel d’OpenAI, plusieurs utilisateurs saluent cette baisse de prix. Un benchmark communautaire classe même GPT-6 Luna premier sur trois tâches exigeantes, pour environ 0,002 $ par tâche.
Le continuum CLI, application, cloud et le travail parallèle
Les testeurs apprécient de pouvoir combiner terminal, interface graphique, worktrees, tâches cloud et fils parallèles. Le test pratique de gradually.ai (24 août 2026) conclut que Claude Code convient mieux à un workflow centré sur le terminal, et Codex à qui veut mélanger toutes ces surfaces. L’auteur relève aussi un modèle de sandbox plus lisible et une voie d’automatisation directe avec codex exec. Sur une petite tâche de correction (6 tests), les deux agents réussissent. Codex termine en 36 secondes contre 83 pour Claude Code, un écart que l’auteur refuse de présenter comme un benchmark.
La hiérarchie des AGENTS.md par dossier, la revue automatique des pull requests et l’exécution autonome dans le cloud reviennent souvent parmi les atouts cités.
La revue de code
La revue est l’un des usages où Codex est le plus recommandé, y compris par des utilisateurs de Claude Code qui l’emploient comme second avis. Des témoignages Hacker News jugent les modèles Sol particulièrement bons pour repérer les cas limites. La revue GitHub se limite volontairement aux problèmes P0 et P1, ce qui répond à la critique la plus fréquente contre les outils de revue automatique : le bruit.
Ce qui est critiqué
Des quotas difficiles à anticiper
C’est la plainte principale, sur r/codex comme sur Hacker News. Firecrawl note que les coupures en cours de fenêtre de 5 heures pèsent plus lourd que ce que suggère le prix affiché. Les témoignages sont très variables : un utilisateur épuise son forfait à 200 en deux jours en utilisant beaucoup le mode `ultra`, un autre son quota hebdomadaire à 100 en trois jours avec Sol en effort élevé. D’autres répondent que ces modes servent justement à dépenser un maximum de tokens et qu’un effort medium suffit la plupart du temps.
Plus inquiétant, plusieurs utilisateurs ont constaté mi-août 2026 que les mêmes projets épuisaient leur quota bien plus vite qu’auparavant, sans annonce. Certains ont accusé OpenAI d’avoir réduit discrètement les limites, et le responsable produit de Codex a publié plusieurs mises à jour sur le sujet. Les sources consultées ne permettent pas de savoir s’il s’agissait d’une modification volontaire ou d’un problème technique. Le constat rappelle que le coût réel d’un forfait dépend autant du modèle, de l’effort et du cache que du prix affiché.
Sur-ingénierie et lenteur des derniers modèles
Un fil r/codex très suivi (plus de 600 votes, relayé le 16 septembre 2026) reproche à GPT-6 Astra de bâtir une infrastructure de vérification non demandée pour une petite fonctionnalité : plusieurs niveaux de tests, empreintes SHA-256, exécutions dans plusieurs ordres. Des utilisateurs disent ne garder que quelques pour cent de leur quota hebdomadaire après une seule demande, ou n’obtenir qu’une dizaine de minutes d’Astra avec le forfait à 20 $.
Le reproche vaut aussi pour Sol en effort xhigh, jugé lent et enclin à « surconstruire » par des utilisateurs de Hacker News. Un autre constate que la relecture répétée des fichiers représente l’essentiel de la dépense, bien avant le raisonnement ou l’écriture du code. Sur le forum d’OpenAI, un développeur trouve Sol trop réfléchi pour un rôle d’orchestrateur. Il propose plutôt de répartir les rôles : Sol pour orchestrer, Luna pour exécuter, Astra pour reprendre et relire.
Des consignes précises indispensables
Le revers de la fiabilité est une moindre tolérance au flou. XDA juge Codex plus lent et moins à l’aise sur les projets qui demandent une compréhension profonde ou des consignes incomplètes. La synthèse vexp lui attribue un plafond plus bas sur les décisions d’architecture et la coordination entre de nombreux fichiers. Lucian Ghinda a dû corriger explicitement des erreurs de gestion de branches.
Un témoignage Hacker News détaillé signale un risque plus sérieux : GPT-5.6 Sol s’est parfois écarté de consignes claires lors d’opérations git destructrices, au point de risquer une perte de données. Le même utilisateur observe que GPT-6 Astra, en effort léger, s’interrompt souvent avant d’avoir terminé ce qu’il annonçait. La conclusion pratique est constante : plan validé, commits fréquents et aucune opération destructrice sans contrôle humain.
Une fusion dans l’application ChatGPT mal vécue par une partie des utilisateurs
Le 9 juillet 2026, l’application Codex est devenue le mode Codex de l’application ChatGPT. Pour les utilisateurs de la CLI, le changement est surtout neutre, mais il a provoqué une série de petites casses. codex app . cherchait encore Codex.app et relançait un installeur, créant un doublon (issue #32631). L’application a parfois disparu du Launchpad sur macOS, et des utilisateurs Windows ont signalé une mauvaise icône et des plantages sur de nouvelles tâches. D’autres regrettent de retrouver leurs conversations personnelles dans ce qui était un outil de travail. Developers Digest conclut que la fusion simplifie l’accès mais oblige à choisir consciemment le bon mode pour chaque tâche.
Sécurité : un bon modèle par défaut, des failles réelles
Le sandbox système activé par défaut est régulièrement salué, mais plusieurs failles sérieuses ont été publiées :
-
Injection via un nom de branche GitHub : BeyondTrust Phantom Labs a montré qu’un nom de branche piégé, masqué par des caractères Unicode invisibles, exécutait une commande lors de la préparation d’une tâche cloud et permettait de voler des jetons GitHub. La faille, jugée critique, touchait le site ChatGPT, la CLI, le SDK et l’extension IDE. Signalée fin décembre 2025, elle a été rapidement corrigée et rendue publique fin mars 2026.
-
Évasions du sandbox « Heapjack » et « Overpatch » : signalées le 12 août 2026 par Accomplish AI, elles ont été corrigées le 20 août (application build 26.818.21641, CLI 0.149.0). La première permettait d’exécuter du code sans approbation depuis l’application de bureau, même en lecture seule. La seconde détournait l’outil de patch de la CLI pour écrire hors du projet.
La réactivité d’OpenAI (huit jours pour la seconde série) est notée positivement. Ces incidents confirment néanmoins les recommandations habituelles : mettre à jour souvent, éviter --yolo hors d’un environnement jetable et traiter tout contenu externe (branches, issues, pages web) comme non fiable.
Un projet ouvert, mais pas communautaire
La CLI est sous Apache-2.0, mais OpenAI n’accepte pas de contributions de code externes : la communauté est invitée à signaler des bugs, fournir des analyses et proposer des idées. Le dépôt compte plus de 18 000 issues et PR ouvertes. Les fonctions les plus différenciantes (cloud, revue GitHub, application de bureau) restent propriétaires et liées à un compte OpenAI. Pour qui cherche un harness réellement ouvert et multi-fournisseurs, OpenCode ou des outils plus minimalistes restent la référence.
Comparaison
Face à Claude Code
Les retours dessinent une répartition des rôles plutôt qu’un vainqueur :
-
Codex est préféré pour exécuter une spécification claire, déléguer en autonomie, relire du code, automatiser en CI et maîtriser le budget.
-
Claude Code est préféré pour comprendre un codebase, travailler à partir d’une demande floue, concevoir l’architecture et itérer en binôme. Plusieurs utilisateurs le trouvent plus riche en fonctions mais plus bavard, et plus prompt à multiplier abstractions et commentaires.
-
Sur les benchmarks de septembre 2026, les chiffres publiés par Anthropic donnent l’avantage à Opus 5.5 (Terminal-Bench 4.0 : 66,4 % contre 57,9 % pour GPT-6 Astra). Les mesures d’Artificial Analysis, relayées par CatDoes, placent Opus 5.5 en effort moyen à 52,5 % pour 1,34
par tâche, contre 43,9 % pour 1,06à GPT-6 Sol en effort maximal. Ces écarts restent sensibles au harness, à l’effort et à la date du test. -
Environ un quart des citations analysées par vexp recommandent d’utiliser les deux. GStack l’organise même explicitement avec sa skill
/codex, qui demande un second avis à Codex depuis Claude Code.
Face à Cursor et aux assistants d’IDE
Cursor garde l’avantage de l’autocomplétion et de la revue visuelle dans l’éditeur, et il est en tête sur les correctifs dans l’étude arXiv. Codex s’utilise dans VS Code et Cursor via son extension, mais son intérêt principal reste la délégation de tâches entières plutôt que l’aide ligne à ligne.
Face à OpenCode et aux harnais ouverts
OpenCode et des harnais comme Pi ou oh-my-pi séduisent les utilisateurs qui veulent choisir leurs modèles et étendre l’outil librement. Certains jugent la CLI de Codex trop dépouillée à côté. D’autres recommandent justement Codex aux non-spécialistes pour sa simplicité « prête à l’emploi ».
Verdict
Codex est l’un des meilleurs agents pour déléguer des tâches bien définies, relire du code et automatiser, avec un rapport coût/usage souvent jugé favorable face à Claude Code, tempéré par des quotas difficiles à anticiper. Il convient particulièrement aux développeurs qui savent écrire une spécification précise, aux équipes qui veulent intégrer un agent à leur CI et à ceux qui passent souvent du terminal au cloud.
Il est moins convaincant quand la demande est floue, que l’architecture reste à inventer ou que le budget de tokens doit être parfaitement prévisible. Les meilleurs retours suivent la même méthode : effort medium par défaut, Luna pour les sous-tâches simples, plan validé avant le code, demande explicite de ne pas sur-tester, commits fréquents et installation à jour. Garder un second agent pour le second avis reste aussi une bonne pratique, qu’il s’agisse de Claude Code pour relire Codex ou de Codex pour relire Claude Code.
Sources
-
TechCrunch — lancement de GPT-6 Sol et Luna (22 septembre 2026)
-
Developers Digest — ChatGPT Work et Codex dans une même application
-
BleepingComputer — évasions du sandbox de Codex (20 septembre 2026)
Sources des avis
| Source | Date | Nature | Fiabilité |
|---|---|---|---|
| Pinna et al. — analyse de 7 156 pull requests | février 2026, révisé en mai 2026 | Étude empirique comparant cinq agents sur neuf types de tâches | Élevée, prépublication non évaluée par les pairs |
| Anthony Maio — Codex Got Better because Claude Code Got Weird | 6 mai 2026 | Analyse argumentée des préférences des développeurs | Moyenne |
| vexp — ce qu’en pensent les développeurs sur Reddit | 5 juin 2026 | Synthèse de commentaires Reddit | Moyenne, méthode peu détaillée |
| XDA Developers — une semaine avec Codex à la place de Claude Code | 5 juin 2026 | Retour d’expérience d’un journaliste | Moyenne |
| Daniel Vaughan — la fusion Codex/ChatGPT vue de la CLI | 17 juillet 2026 | Recensement des régressions et contournements | Élevée pour les issues citées |
| Developers Digest — ChatGPT Work et Codex dans une même application | juillet 2026 | Présentation des changements et conseils d’usage | Moyenne |
| Firecrawl — meilleurs agents de code en 2026 | mis à jour le 3 août 2026 | Comparatif de benchmarks éditeurs et de retours communautaires | Moyenne |
| Tech Insider — écart de coût par tâche entre Claude Code et Codex | juillet 2026, mis à jour en août | Synthèse des mesures de Firecrawl et de Morph | Moyenne, chiffres de seconde main |
| Lucian Ghinda — une semaine à utiliser Codex plus que Claude | 21 août 2026 | Comparaison sur un même codebase Rails | Moyenne, un seul projet |
| Hacker News — discussion de l’article de Lucian Ghinda | août 2026 | Nombreux témoignages sur les quotas, le style et les modèles | Faible à moyenne |
| gradually.ai — test pratique Claude Code contre Codex | 24 août 2026 | Test reproductible sur une petite tâche | Moyenne, cas unique |
| Ask HN — premières impressions sur GPT-6 Astra | septembre 2026 | Témoignages sur Astra et Sol dans Codex | Faible à moyenne |
| explainx.ai — réactions Reddit à GPT-6 Astra dans Codex | 16 septembre 2026 | Relais d’un fil r/codex | Faible à moyenne, fil original non lié |
| Forum OpenAI — annonce de GPT-6 Sol et Luna | septembre 2026 | Retours d’utilisateurs et benchmark communautaire | Faible à moyenne |
| CatDoes — Claude Code contre Codex : Opus 5.5 contre GPT-6 Sol | 24 septembre 2026 | Comparatif mêlant chiffres éditeurs et mesures d’Artificial Analysis | Moyenne |
| SiliconANGLE — injection de commande via un nom de branche | 30 mars 2026 | Compte rendu d’une divulgation de BeyondTrust | Élevée |
| BleepingComputer — évasions du sandbox de Codex | 20 septembre 2026 | Compte rendu de divulgation avec réponse d’OpenAI | Élevée |
| Politique de contribution du dépôt openai/codex | septembre 2026 | Document officiel | Élevée, non indépendante |
Dernière analyse : 12 novembre 2026