Premier « System One Model » de TypeSafe AI : un modèle propriétaire qui ne génère pas de texte. Il répond à des questions typées (choix, note, oui/non) sur un état fourni, avec des probabilités présentées comme calibrées et un score de confiance (la calibration est inégale selon les tests indépendants). Accessible par API, il sert aux décisions rapides et massives que le code exploite directement : classer, router, noter, extraire, filtrer ou vérifier.
Composition : 1 skill (typesafe-ai, pour agents de code).
Voir aussi : la section Avis indépendants pour une synthèse des tests et opinions publiés, et Jev mémo pour l’API, le SDK et les limites.
Résumé
Jev est le premier modèle public de TypeSafe AI, un laboratoire de San Francisco fondé en 2024 par Diogo Almeida, Erik Gafni et Sasha Sheng. Diogo Almeida vient d’OpenAI, où il a travaillé sur les méthodes de suivi d’instructions à l’origine de ChatGPT. L’entreprise est sortie de deux ans de discrétion le 15 septembre 2026, avec une levée d’amorçage de 40 M menée par DCVC (valorisation de 200 M selon Forbes). TypeSafe décrit Jev comme un appel de fonction doté d’une intelligence de pointe : un état non structuré en entrée, des décisions probabilistes typées en sortie.
Jev ne produit pas de texte token par token. On lui envoie un state (texte, objet JSON ou tableau) et une série de questions nommées de trois types : Choice (une option parmi une liste de 255 au plus), Score (une position sur une échelle ordonnée de 2 à 10 niveaux) et Noul (la probabilité qu’un énoncé soit vrai). Toutes les questions sont évaluées en parallèle, en une seule passe, si bien qu’en ajouter change peu la latence. La réponse ne peut pas sortir du schéma : pas d’erreur de type, pas d’option inventée. C’est ce que TypeSafe appelle « ne pas pouvoir halluciner », ce qui ne garantit pas pour autant que la réponse soit juste.
Le modèle est entraîné par RLCD (Reinforcement Learning for Calibrated Decisions), une méthode qui optimise des probabilités « épistémiquement honnêtes » plutôt que la préférence d’annotateurs humains (RLHF) ou des récompenses vérifiables par programme (RLVR). Les données d’entraînement sont entièrement synthétiques et produites par TypeSafe, qui se présente comme un « laboratoire de données ». L’entreprise s’engage à ne pas entraîner ses modèles sur les données clients. L’architecture n’est pas publiée : TypeSafe affirme seulement que Jev n’est « ni petit, ni un LLM ». Le nom « System One » vient du Système 1 de Daniel Kahneman (pensée rapide et intuitive). « Jev » renvoie à William Stanley Jevons et à son paradoxe : chaque baisse du coût de l’intelligence devrait en multiplier les usages.
Les chiffres annoncés sont de **0,042 par million de tokens en entrée** (42 le milliard), sortie gratuite, et une latence de bout en bout de 70 à 500 ms, soit 40 à 200 fois plus rapide qu’un LLM de pointe sur ce type de tâche. Sur ses propres « workflow evals » (4 workflows métier, avec pour référence la moyenne de GPT-6 Astra et de Claude Fable 5.1), Jev obtient 67,8 % d’accord. C’est le niveau de Sonnet 5 (67,8 %) et de GPT-5.6 Terra (67,9 %), en dessous de Sol (74,1 %) et d’Opus 5 (73,1 %), pour 0,0004 $ et 0,4 s par cas. De là viennent les chiffres de la page d’accueil : 193,6 fois plus rapide et 444,6 fois moins cher. TypeSafe reconnaît que ces gains se situent en haut de la fourchette réelle et refuse de publier des résultats sur les benchmarks publics.
L’accès a beaucoup bougé la première semaine. D’abord sur liste d’attente, l’API a été ouverte à tous le 20 septembre avec 5 $ de crédit offert (environ 120 millions de tokens), puis les inscriptions ont été suspendues le 22 septembre face à la demande. Elles l’étaient encore le 24 septembre. Jev reste accessible par Vercel AI Gateway, OpenRouter et Cloudflare Workers AI. La version courante est jev-1.13.0, derrière les alias jev-latest et jev-preview. Selon The Information, relayé par RuntimeWire, près de 13 % des équipes payantes de Vercel l’ont essayé dans les 24 heures suivant le lancement, un record pour la passerelle.
Fonctionnalités
-
Trois primitives typées :
choicerenvoie l’option retenue, la probabilité de chaque option et une confiance.scorerenvoie une position (éventuellement entre deux niveaux), la distribution sur les niveaux et une confiance.noulrenvoie une valeur de 0 à 1, la probabilité que la réponse soit oui. -
Évaluation parallèle et « fan-out » spéculatif : toutes les questions d’une requête partagent le même
stateet sont évaluées indépendamment et simultanément. On peut poser d’emblée des questions qui ne serviront que dans certaines branches (gravité d’un bug, demande de remboursement…) et laisser le code trier ensuite. -
Confiance exploitable : chaque Choice et Score porte un champ
confidencecalculé à partir de la forme de la distribution. La documentation propose trois zones (agir, confirmer, escalader) et des seuils proportionnés au risque de l’action. -
State et instructions structurés : le
stateaccepte une chaîne, un objet ou un tableau. Les instructions, options, niveaux et critères acceptent aussi du JSON (définitions, exemples, données de référence citées entre backticks). -
API HTTP unique :
POST https://api.typesafe.ai/v1/systemonepour évaluer etGET /v1/modelspour lister les modèles. Les aliasjev-latestetjev-previewsuivent les nouvelles versions, et un identifiant versionné (jev-1.13.0) permet de figer les seuils calibrés. -
SDK officiels : Python (
typesafe-sdk, Python ≥ 3.10, clients synchrone et asynchrone,response_modelPydantic, politique de retry) et JavaScript/TypeScript (@typesafe-ai/sdk, Node ≥ 20, types de réponse inférés depuis les questions). Les deux sont sous licence MIT. -
Passerelles et intégrations tierces : Vercel AI Gateway (
typesafe-ai/jev), OpenRouter (~typesafe/jev-latest), Cloudflare Workers AI (typesafe/jev), classifieur de l’Auto Router de LiteLLM (classifier_type: jev), Pydantic AI (typesafe:jev-latest) et pluginllm-typesafepour l’outil LLM de Simon Willison. -
Skill pour agents de code : le dépôt
typesafe-ai/skills(MIT) s’installe comme plugin Claude Code ou vianpx skillspour Codex et les autres agents. Il apprend à l’agent à écrire du code qui appelle Jev. Jev lui-même ne peut pas servir de modèle à un agent de code. -
Adaptateur « System One » pour LLM :
system-one-adapter-python(MIT) reproduit l’interface deTypeSafeClientau-dessus d’OpenAI, d’Anthropic ou de Gemini, pour comparer coût, vitesse et justesse sur ses propres données. -
Cookbooks et patterns : 18 recettes complètes (re-ranking, garde-fous d’entrée et de sortie d’un LLM, vérification de citations, appel de fonctions, suggestion de skills parmi les 182 du catalogue de Hermes Agent, classification hiérarchique, extraction de dates, cascade d’extraction…) et quatre patterns d’architecture (fan-out, routage par confiance, score composite, routage d’intention).
-
Données : pas d’entraînement sur les requêtes clients, conservation zéro (ZDR) proposée aux entreprises, poids identiques pour tous les comptes (pas de fine-tuning ni de LoRA par client).
Analyse
| Critère | Note |
|---|---|
| Documentation | ★★★★★ |
| Précision des descriptions | ★★★☆☆ |
| Coût et latence | ★★★★★ |
| Calibration vérifiée | ★★★☆☆ |
| Maturité | ★☆☆☆☆ |
| Popularité | — |
Notes Documentation, Précision et Maturité alignées sur le barème global (10 octobre 2026). Popularité non notée : pas de dépôt public.
Points forts
-
Coût et latence confirmés par des tests indépendants : dans le banc d’essai de LiteLLM, Jev classe les requêtes 5,4 fois plus vite que Claude Haiku 4.5 en médiane (127 ms contre 688 ms) pour 96 % de coût en moins. Dans un test de triage sous charge, il coûte 0,048 $ pour 1 000 décisions correctes, sans dérive quand le trafic augmente.
-
Sorties typées par construction : plus de JSON à parser, de relances sur réponse mal formée ni de refus inattendus au milieu d’un pipeline. La réponse s’insère directement dans un
if, unswitchou un tri. -
Un vrai signal d’incertitude : dans le test de WotAI, Jev place 34,7 % des cas ambigus en zone intermédiaire, contre 2,7 % pour Haiku, ce qui permet d’écrire des règles d’escalade. La plupart des LLM renvoient des confiances précises en apparence mais peu informatives.
-
Zéro-shot, tâche définie à l’exécution : contrairement à un classifieur de type BERT, aucun jeu étiqueté ni fine-tuning n’est nécessaire. La tâche est décrite dans le texte de la question et peut changer d’un appel à l’autre.
-
Documentation honnête : le billet de lancement détaille les biais de ses propres évaluations, et une page « jaggedness » recense les modes d’échec connus de
jev-1.13avec, pour chacun, la façon de le contourner. -
Écosystème immédiat : SDK, skill pour agents, adaptateur de comparaison et disponibilité sur Vercel, Cloudflare et OpenRouter dès la première semaine.
Limites
-
Aucune génération ni explication : Jev ne rédige pas, ne justifie pas ses réponses et ne peut pas piloter un agent. Un LLM reste nécessaire à côté, et le diagnostic d’une erreur se fait « en boîte noire ».
-
Faiblesses documentées : lecture très littérale des consignes, calcul et comptage peu fiables, comparaison de dates, raisonnements à plusieurs étapes, perte de précision quand le
statecontient beaucoup d’informations inutiles. Il reste aussi sensible au contenu adverse (instructions injectées dans lestate). L’arithmétique et la logique doivent rester dans le code. -
« Ne peut pas halluciner » à nuancer : la garantie porte sur le respect du schéma, pas sur la justesse. Une réponse fausse avec une forte confiance reste possible, et la calibration varie selon les tests (erreur de calibration de 0,154 contre 0,097 pour Haiku sur un test de phishing).
-
Précision sensible à la formulation : sur le même test de phishing, Jev passe de 62,6 % avec une seule question à 95,0 % quand le jugement est décomposé en cinq questions pondérées sur 1 000 exemples étiquetés. Le travail de décomposition incombe au développeur.
-
Limites techniques : 64k tokens par requête, 32k pour le
stateet la plus longue question, texte uniquement (ni image, ni audio), meilleure précision en anglais. -
Accès et conditions instables : liste d’attente, ouverture puis suspension des inscriptions en une semaine, limites de débit « ajustées dynamiquement » et susceptibles de changer sans préavis. TypeSafe admet ne pas pouvoir prouver que son prix n’est pas subventionné.
-
Service fermé et évaluations maison : modèle propriétaire à fournisseur unique, architecture non divulguée, chiffres de lancement produits par l’équipe de TypeSafe avec pour référence la moyenne d’autres modèles plutôt qu’une vérité terrain.
Qualité
Commentaire : la documentation est remarquable pour un produit d’une dizaine de jours : primitives, patterns, 18 cookbooks, SDK référencés et une liste franche des modes d’échec. La précision des descriptions perd deux étoiles, car le discours marketing (« frontier model », « ne peut pas halluciner », « jusqu’à 200 fois plus rapide ») va plus loin que ce que la documentation et les tests indépendants confirment, même si le billet de lancement en expose lui-même les nuances. Le couple coût/latence est la vraie force du produit et se vérifie partout. La calibration est prometteuse mais inégale selon les tâches. La maturité reste faible : une seule version du modèle, un accès qui a changé trois fois en une semaine, des limites mouvantes et aucun recul en production.
Relations
-
Alternative à : LLM légers utilisés comme classifieurs (Claude Haiku 4.5, GPT-5.6 Luna, DeepSeek V4 Flash), LLM-as-a-judge, classifieurs de type BERT fine-tunés, GLiClass, Laya (modèle de décision à poids ouverts)
-
Complémentaire de : LLM génératifs pour rédiger, expliquer et raisonner (cascades Jev → LLM, garde-fous avant et après un LLM) ; Hermes Agent, dont le catalogue de skills sert d’exemple au cookbook de suggestion de skills
-
S’intègre avec : Vercel (AI Gateway), Cloudflare Workers AI, OpenRouter, LiteLLM, Pydantic AI, LangChain, LLM (CLI de Simon Willison), Claude Code et OpenAI Codex via la skill
typesafe-ai -
Utilise : RLCD, données d’entraînement synthétiques, API HTTP
/v1/systemone, SDK Python et TypeScript, Skills
Mémo pratique
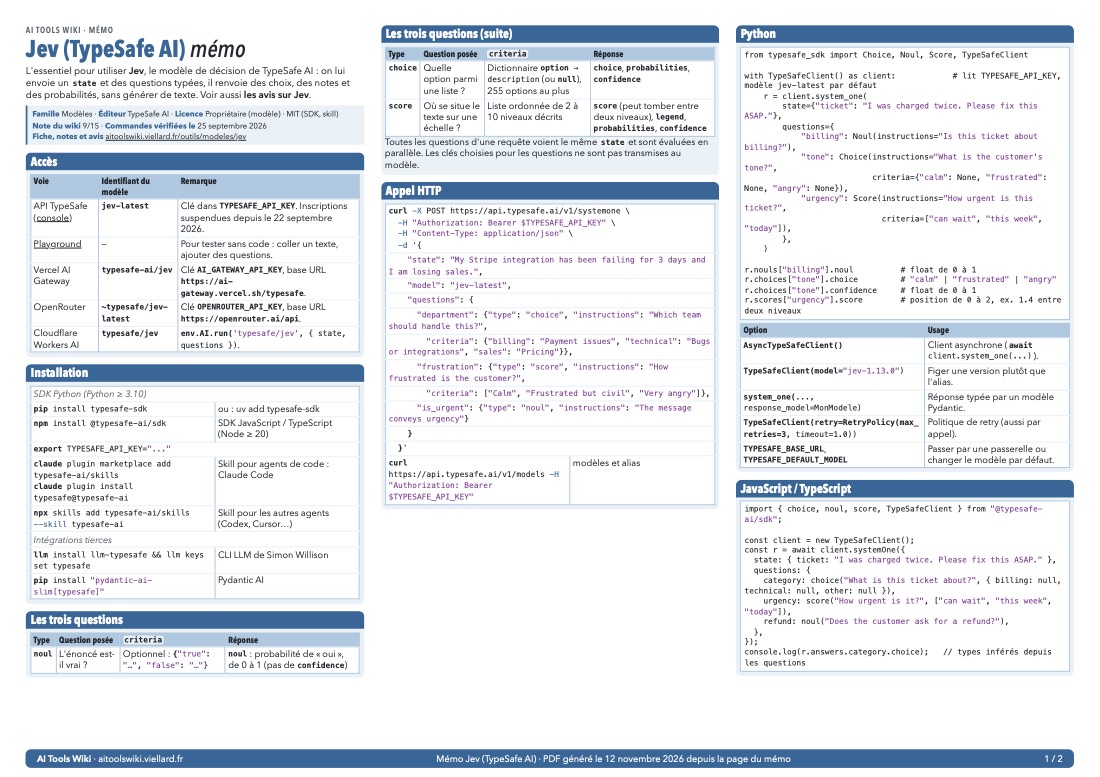
Télécharger le mémo en PDF (2 pages A4 paysage, 302 Ko). Il est généré depuis la page du mémo, qui reste la version de référence : commandes à copier, recherche dans le site.
Avis indépendants
Synthèse des tests, discussions et critiques publiques sur Jev, le modèle de décision de TypeSafe AI. Relevé le 25 septembre 2026, dix jours après le lancement. Voir aussi Jev mémo.
En bref
| Aspect | Tendance des retours |
|---|---|
| Coût et latence | Très positive, confirmée par tous les tests indépendants |
| Précision sur les tâches de classification simples | Positive : au niveau des petits LLM, parfois au-dessus |
| Précision sur les jugements complexes ou ambigus | Mitigée : dépend beaucoup de la décomposition en questions |
| Calibration et score de confiance | Mitigée : bon signal d’incertitude, calibration inégale selon les tâches |
| Promesse « ne peut pas halluciner » | Négative : jugée trompeuse, elle garantit le format, pas la justesse |
| Nouveauté du concept | Débattue : « un BERT moderne » pour les uns, une vraie nouvelle catégorie pour les autres |
| Marketing et chiffres annoncés | Négative : gains de 200 à 400 fois non reproduits hors des évaluations maison |
| Expérience développeur et documentation | Positive |
| Accès (liste d’attente, inscriptions, limites) | Négative : accès changeant et limites instables |
| Recul critique disponible | Faible à moyen : nombreux tests ponctuels, aucune étude indépendante de fond |
Le lancement a fait l’effet d’un événement : plus de 1 900 points et 500 commentaires sur Hacker News, une adoption record sur Vercel AI Gateway et une intégration par LiteLLM, Pydantic AI, Cloudflare et OpenRouter en quelques jours. L’opinion dominante est favorable au produit : un modèle très bon marché et très rapide, qui renvoie des décisions typées et un score de confiance directement utilisables dans du code. Les tests indépendants confirment l’essentiel des gains de coût et de latence, avec une précision proche de celle des petits LLM sur les tâches de classification.
Elle est beaucoup plus réservée sur le discours. « Frontier model », « ne peut pas halluciner », « 200 fois plus rapide » : ces formules sont largement contestées. Les gains mesurés par des tiers sont réels mais bien plus modestes (de 2 à 7 fois plus rapide, de 5 à 50 fois moins cher selon les cas). La calibration, argument central de TypeSafe, se vérifie de façon inégale. Le consensus décrit Jev comme un excellent filtre ou aiguillage à placer devant ou autour des LLM, pas comme leur remplaçant.
Ce qui est apprécié
Un rapport coût/latence spectaculaire, confirmé par des tiers
C’est le point sur lequel tous les retours s’accordent. Le banc d’essai de LiteLLM (septembre 2026) teste Jev comme classifieur de l’Auto Router, qui choisit le niveau de modèle adapté à chaque requête. Sur 80 cas répétés trois fois, Jev retrouve le niveau attendu dans 95,0 % des appels, contre 73,75 % pour Claude Haiku 4.5. Il est 5,4 fois plus rapide en médiane (127 ms contre 688 ms) et coûte 0,0077 contre 0,1985 pour les 240 appels. Les étiquettes ont toutefois été rédigées par l’auteur, sans relecture indépendante.
Suraj Phanindra (21 septembre 2026) mesure le coût de 1 000 décisions à la fois correctes et rendues à temps sur un triage de tickets bancaires (CLINC150, 30 intentions). La précision est statistiquement équivalente (92,2 % pour Jev, 93,6 % pour GPT-5.6 Luna et Haiku 4.5). Jev reste stable à 0,048 pour 1 000 décisions quand la charge augmente, alors que le coût de Haiku grimpe jusqu'à 24,48 à 40 tickets par seconde, faute de capacité. L’auteur précise que l’écart tient surtout à la file d’attente et se réduit à environ 3,3 fois face à Luna avec plus de parallélisme.
Chez Vercel, remplacer Luna par Jev a donné des résultats 5 à 18 fois plus rapides, selon TechCrunch. Le CTO de Bryo AI juge Gemini légèrement plus précis sur son tri d’e-mails, mais 10 à 20 fois plus cher. Ves Stoyanov (Lightfield, 20 septembre 2026) obtient 90 % de bonnes réponses sur 40 questions portant sur un article de 20 000 tokens, contre 92,5 % pour Opus 5, pour 0,84 les 1 000 questions contre 129,69, et 429 ms contre 2 252 ms.
Des décisions typées qui simplifient le code
Les développeurs apprécient de ne plus parser de JSON, relancer les réponses mal formées ou gérer des refus au milieu d’un pipeline. Flavio Copes résume l’intérêt par l’image d’un if intelligent, où une condition floue devient une probabilité typée. Simon Willison y voit une nouvelle forme de modèle, du texte en entrée et seulement des nombres en sortie, et a publié dès le 22 septembre un plugin llm-typesafe pour son outil LLM. Pour Laurie Voss (O’Reilly, 23 septembre 2026), le coût change l’économie des applications d’IA : on peut vérifier chaque sortie d’un LLM au lieu d’en contrôler un échantillon.
Le fait que la tâche soit décrite à l’exécution, sans jeu d’entraînement ni fine-tuning, revient souvent. Sur Hacker News, un commentateur souligne qu’on règle ainsi un problème de classification arbitraire en quelques minutes au lieu d’une semaine.
Un modèle qui sait dire « je ne sais pas »
Alex Kim (WotAI, 18 septembre 2026) a comparé 16 modèles sur la classification de 150 passages selon le style d’écriture. En précision, Jev fait jeu égal avec Haiku (66,0 %), derrière GLM-5.3-flash (74 %) et Sonnet 5 (71,3 %). Sa calibration est comparable à celle de Haiku (erreur de 0,121 contre 0,122), moins bonne que celle de Sonnet 5 (0,062), mais Jev est le plus rapide (455 ms en médiane). Surtout, il place 34,7 % des cas en zone intermédiaire, contre 2,7 % pour Haiku. L’auteur y voit la vraie différence : un modèle qui signale ses doutes permet d’écrire des règles d’escalade, alors que la plupart des LLM renvoient des confiances précises en apparence mais inexploitables.
Armin Ronacher (Earendil) apprécie de recevoir une vraie probabilité, en rappelant qu’un 50 % doit se lire comme un pile ou face. Le dépôt de tests jev-eval observe aussi que les prédictions proches de 0 ou de 1 sont très fiables.
Une documentation et une communication jugées honnêtes
Le billet de lancement accompagne chaque affirmation d’une section « Nuance » qui reconnaît les biais de ses propres évaluations. La documentation consacre une page entière aux défauts connus de jev-1.13. Plusieurs auteurs saluent cette transparence, rare lors d’un lancement de modèle, même si elle contraste avec les titres de la page d’accueil.
Ce qui est critiqué
« Ne peut pas halluciner » : une promesse sur le format, pas sur le fond
C’est la critique la plus répandue, sur Hacker News comme chez KDnuggets, eesel ou lalospace. Jev ne peut pas renvoyer une valeur hors du schéma, mais il peut choisir la mauvaise option avec une forte confiance. Plusieurs commentateurs estiment que c’est une hallucination sous un autre nom. TypeSafe reconnaît d’ailleurs que son « 0 % » n’est pas mesuré mais découle de la conformité au schéma. Diogo Almeida, présent dans le fil Hacker News, répond qu’on ne dit pas non plus d’une forêt aléatoire qu’elle hallucine. Anthony Maio résume le débat : Jev contraint la forme de la réponse, pas le jugement.
Des chiffres de lancement non reproduits
Les gains de 193,6 fois en vitesse et 444,6 fois en coût viennent des évaluations maison. Les workflows ont été écrits par l’équipe de TypeSafe, et la référence est la moyenne de GPT-6 Astra et de Claude Fable 5.1, pas une vérité terrain. KDnuggets (21 septembre 2026) rappelle que les 67,8 % d’accord de Jev restent sous ceux de Sol (74,1 %) et d’Opus 5 (73,1 %) sur ces mêmes évaluations. Les tests indépendants mesurent des accélérations de 1,4 à 3,7 fois (WotAI), 2,9 fois (test de phishing) ou 5,4 fois (LiteLLM), loin du « 20 à 200 fois ». L’écart s’explique en partie par le choix des comparaisons : un LLM génératif fait bien plus de travail qu’un classifieur. Le refus de TypeSafe de publier des scores sur des benchmarks publics nourrit aussi la méfiance.
Une précision qui dépend de la formulation
Le test de phishing publié par Anisselbd le 17 septembre et relayé par XenoSpectrum est le plus cité. Sur 2 000 e-mails, avec une seule question, Jev obtient 62,6 % contre 81,3 % pour Haiku 4.5. En décomposant le jugement en cinq questions dont les poids sont ajustés sur 1 000 e-mails étiquetés, Jev monte à 95,0 %, alors que Haiku ne gagne rien à la décomposition. Sur la question unique, la calibration de Jev est aussi moins bonne (erreur de 0,154 contre 0,097). L’auteur précise qu’il s’agit d’un essai unique, sur un jeu de données presque séparable.
Le dépôt jev-eval (300 exemples par jeu de données) confirme le schéma : 98,7 % sur Enron spam, 95,7 % sur SST-2 et 91,3 % sur AG News, au-dessus de GPT-5.4-mini et de GPT-5.6 Luna, mais 76,0 % sur Banking77 (77 intentions) contre 81,7 % pour Luna. Les probabilités intermédiaires y ont peu de valeur prédictive. Lightfield observe aussi une baisse nette sur des questions-réponses Amazon bruitées (62,8 % contre 73 % pour la référence). La conclusion commune : Jev excelle sur des textes courts avec des catégories nettes, mais une tâche ambiguë doit être découpée en questions atomiques, ce qui demande des données étiquetées et du travail d’ingénierie.
Une calibration à vérifier soi-même
La calibration est l’argument central de TypeSafe, et c’est aussi ce qui manque le plus de preuves indépendantes. AgentConn résume l’enjeu : le concept tient si la calibration tient, et il faudra des courbes de fiabilité sur des données réelles pour le démontrer. Les résultats publiés sont contrastés. Jev exprime mieux l’incertitude que les petits LLM (WotAI), mais sa calibration est moins bonne que celle de Haiku sur le phishing. Le dépôt jev-eval trouve la confiance fiable aux extrêmes mais peu informative dans la zone intermédiaire, là où se prennent les décisions les plus délicates. La recommandation qui revient partout : faire tourner Jev en parallèle de l’existant et mesurer sa propre calibration avant de fixer des seuils.
« Juste un BERT avec plus de données » ?
Le débat sur la nouveauté est vif. Sur r/LocalLLaMA, le commentaire le plus voté décrit Jev comme un modèle de type BERT doté des données, du calcul et de la recette d’entraînement des LLM modernes. Merve Noyan (Hugging Face) regrette l’absence de comparaison avec des BERT fine-tunés, les vrais concurrents selon elle. Alexis Gallagher rappelle que les classifieurs encodeurs existent depuis des années. Lucas Beyer ironise sur le mystère des usages possibles. Sebastian Raschka voit la vraie avancée dans la capacité à généraliser à des tâches nouvelles, en situant le secret plutôt dans les données que dans l’algorithme. KDnuggets et lalospace concluent à du très bon travail d’ingénierie produit plutôt qu’à une rupture scientifique. L’architecture n’étant pas publiée, le débat reste ouvert.
Une boîte noire aux biais invisibles
Simon Willison (21 septembre 2026) relève le revers de l’absence de texte : aucune explication n’accompagne la réponse, ce qui ramène à l’apprentissage automatique en boîte noire. En faisant noter des villes de la baie de San Francisco, il obtient un classement qui laisse deviner des biais implicites (Cupertino en tête, East Palo Alto en dernier). Il met en garde contre l’usage de Jev pour classer des candidats à un emploi. La documentation reconnaît de son côté une sensibilité aux contenus adverses : des instructions injectées dans le state peuvent déplacer la réponse.
Un accès chaotique
La première semaine a été agitée : liste d’attente au lancement, API brièvement saturée par la demande (TechCrunch), ouverture à tous le 20 septembre avec 5 $ de crédit, puis inscriptions suspendues le 22 septembre et toujours fermées le 24. Les limites de débit (250 000 tokens par seconde, 1 200 requêtes par minute) sont annoncées comme « ajustées dynamiquement » et susceptibles de changer sans préavis. Diogo Almeida reconnaît que TypeSafe restera contraint par les GPU pendant longtemps, et l’entreprise admet ne pas pouvoir prouver que son prix n’est pas subventionné. Plusieurs projets open source ajoutent des fournisseurs de repli (Vercel AI Gateway, Cloudflare Workers AI, OpenRouter) et une gestion explicite des pannes de Jev.
Comparaison
Tests publiés
| Test | Tâche | Précision de Jev | Référence | Vitesse et coût |
|---|---|---|---|---|
| LiteLLM | Routage vers 4 niveaux de modèle (240 appels) | 95,0 % | Haiku 4.5 : 73,75 % | 5,4 × plus rapide, −96 % de coût |
| Suraj Phanindra | Triage CLINC150, 30 intentions | 92,2 % | Luna et Haiku 4.5 : 93,6 % | 0,048 $ pour 1 000 décisions correctes, stable sous charge |
| WotAI | Style d’écriture (150 passages, 16 modèles) | 66,0 % | Haiku 4.5 : 66,0 % · Sonnet 5 : 71,3 % | Le plus rapide (455 ms), 1,4 à 3,7 × plus rapide |
| Anisselbd / XenoSpectrum | Phishing (2 000 e-mails) | 62,6 % (1 question) · 95,0 % (5 questions) | Haiku 4.5 : 81,3 % | ≈ 2,9 × plus rapide, ≈ 12 × moins cher |
| jev-eval | Enron, SST-2, AG News, Banking77 | 98,7 % · 95,7 % · 91,3 % · 76,0 % | Luna : 81,7 % sur Banking77 | 5 à 56 × moins cher |
| Lightfield | Questions sur un long article (20k tokens) | 90 % | Opus 5 : 92,5 % | 150 × moins cher, 5 × plus rapide |
| TypeSafe (maison) | 4 workflows métier | 67,8 % d’accord | Sol : 74,1 % · Opus 5 : 73,1 % | 193,6 × plus rapide, 444,6 × moins cher |
Ces tests sont ponctuels, souvent menés par une seule personne et sur des jeux de données différents. Ils ne sont pas comparables entre eux, mais dessinent une tendance cohérente.
Face aux petits LLM (Haiku, Luna, DeepSeek Flash)
Sur des classifications nettes, Jev atteint une précision équivalente pour un coût et une latence bien inférieurs. L’avantage se creuse quand on pose plusieurs questions sur le même texte, grâce à l’évaluation parallèle. Les petits LLM gardent l’avantage sur les jugements formulés en une seule question complexe, sur les catégories nombreuses et proches, et bien sûr dès qu’il faut produire du texte ou une justification.
Face aux classifieurs ouverts (BERT, GLiClass, Laya)
Un classifieur fine-tuné reste compétitif, voire meilleur, quand on dispose de données étiquetées et d’une tâche stable. Laya, un modèle de décision à poids ouverts de Convai Innovations (Apache-2.0, 421 millions de paramètres, fondé sur ModernBERT), s’exécute en local en 33 ms. Selon Flowtivity, il n’est toutefois compétitif qu’après fine-tuning sur des milliers d’exemples : en zéro-shot, sa précision s’effondre (0,36). Des recréations ouvertes comme Kev (à partir de Qwen) sont apparues en quelques jours. L’avantage de Jev tient au zéro-shot : une nouvelle tâche se définit en une phrase.
Face aux LLM de pointe
Opus 5, Sol ou Sonnet 5 restent plus précis sur les jugements difficiles et mieux calibrés (Sonnet 5 dans le test de WotAI), mais ils sont trop lents et trop coûteux pour servir d’aiguillage à chaque requête. Le schéma recommandé par la plupart des retours est une cascade : Jev tranche les cas nets, et les cas à faible confiance remontent vers un LLM de raisonnement ou un humain.
Verdict
Jev est une brique très utile et réellement nouvelle par son prix : des décisions typées, accompagnées d’une probabilité, en quelques centaines de millisecondes et pour une fraction de centime. Il convient particulièrement au routage de requêtes, au triage, à la modération, aux garde-fous autour d’un LLM, au filtrage de gros volumes et à l’extraction guidée par des options connues. Il excelle quand la question est simple et la catégorie nette.
Il est moins convaincant sur les jugements ambigus posés en une seule question, sur tout ce qui touche au calcul, aux dates ou au raisonnement en plusieurs étapes, et partout où il faut expliquer une décision. Les meilleurs retours suivent la même méthode : découper chaque jugement en questions atomiques, garder la logique et l’arithmétique dans le code, figer la version du modèle, mesurer sa propre calibration en parallèle de l’existant avant de fixer des seuils, et faire remonter les cas à faible confiance vers un LLM ou un humain. Vu l’instabilité de l’accès, prévoir un fournisseur de repli (Vercel, Cloudflare ou OpenRouter) reste prudent.
Sources
-
Billet de lancement — Introducing System One Models & Jev (15 septembre 2026)
-
RuntimeWire — adoption sur Vercel AI Gateway et valorisation (24 septembre 2026)
-
Flavio Copes — accès à Jev et clé d’API (mis à jour le 24 septembre 2026)
Sources des avis
| Source | Date | Nature | Fiabilité |
|---|---|---|---|
| TypeSafe — billet de lancement | 15 septembre 2026 | Annonce officielle avec sections de nuance | Élevée pour les faits, non indépendante pour les chiffres |
| TypeSafe — workflow evals | septembre 2026 | Évaluations maison sur 4 workflows | Moyenne : référence construite à partir d’autres modèles |
| Hacker News — fil de lancement | septembre 2026 | Plus de 500 commentaires, réponses du fondateur | Faible à moyenne |
| Latent Space — AINews | 16 septembre 2026 | Revue des réactions sur X | Moyenne |
| Anisselbd / XenoSpectrum — test de phishing | 17 et 20 septembre 2026 | Test reproductible commenté | Moyenne : essai unique, jeu presque séparable |
| lalospace — Jev and the hype machine | 17 septembre 2026 | Critique du discours marketing | Moyenne |
| TechCrunch — A new kind of AI model… | 18 septembre 2026 | Article de presse avec témoignages de développeurs | Moyenne à élevée |
| WotAI — Jev contre 15 autres modèles | 18 septembre 2026 | Test de précision, calibration et latence | Moyenne : étiquettes imparfaites reconnues |
| LiteLLM — Jev comme classifieur de l’Auto Router | septembre 2026 | Banc d’essai d’un intégrateur | Moyenne : étiquettes de l’auteur, corpus unique |
| Lightfield — Jev sur la compréhension de texte | 20 septembre 2026 | Tests sur benchmarks publics et jeux métier | Moyenne |
| Simon Willison — notes sur Jev | 21 septembre 2026 | Analyse et essais d’un développeur reconnu | Moyenne à élevée |
| Suraj Phanindra — What a correct decision costs | 21 septembre 2026 | Test sous charge avec méthodologie détaillée | Moyenne à élevée |
| KDnuggets — What everyone is getting wrong about Jev | 21 septembre 2026 | Analyse critique | Moyenne |
| AgentConn — Jev, if calibration holds | 21 septembre 2026 | Revue des réactions (Reddit, X) et analyse | Moyenne, citations de seconde main |
| eesel AI — TypeSafe Jev review | 21 septembre 2026 | Synthèse documentaire, sans test propre | Faible à moyenne |
| Flowtivity — Laya contre Jev | 21 septembre 2026 | Comparaison avec une alternative ouverte | Moyenne |
| snaga — personnalisation Hacker News avec Jev (gist, en japonais) | 21 septembre 2026 | Expérience de filtrage multidimensionnel | Faible à moyenne, 20 articles |
| O’Reilly Radar — Will Jev change how we build AI applications? | 23 septembre 2026 | Tribune favorable | Moyenne |
| jev-eval — Jev contre GPT-5.4-mini et GPT-5.6 Luna | septembre 2026 | Test sur quatre jeux publics, données publiées | Moyenne |
| Flavio Copes — analyse de Jev | mis à jour le 24 septembre 2026 | Analyse d’usage et plan d’adoption prudent | Moyenne |
| RuntimeWire — adoption sur Vercel et valorisation | 24 septembre 2026 | Relais de The Information | Moyenne, chiffres de seconde main |
| Latent Space — entretien avec Diogo Almeida | septembre 2026 | Entretien avec le fondateur | Moyenne, point de vue de l’éditeur |
| TypeSafe — modes d’échec de jev-1.13 | 17 septembre 2026 | Documentation officielle | Élevée, non indépendante |
Dernière analyse : 12 novembre 2026