Transforme un codebase et ses ressources associées en knowledge graph interrogeable, exploitable directement par les coding agents. Graphify combine parsing AST déterministe, relations explicites et inférées, détection de communautés et interface MCP, sans utiliser de vector store pour le graphe de code.
Voir aussi : la section Avis indépendants pour une synthèse des retours et réserves, et Graphify mémo pour le mémo pratique.
Résumé
Graphify est un outil open source de code intelligence et de knowledge graph conçu pour donner aux agents une représentation persistante et structurée d’un projet.
Il analyse le code avec Tree-sitter, mais peut également intégrer documentation, schémas SQL, configurations, PDF, images, vidéos et autres sources. Le résultat est un graphe stocké notamment dans graph.json, accompagné d’un rapport Markdown et d’une visualisation HTML.
Son originalité principale est de remplacer une recherche classique dans les fichiers ou un RAG vectoriel par une navigation explicite dans les relations entre concepts : imports, appels, héritage, dépendances, chemins entre composants, communautés, etc.
Chaque relation porte une information de provenance, notamment EXTRACTED lorsqu’elle est directement observée dans la source et INFERRED lorsqu’elle est déduite par Graphify.
Le projet fournit une /graphify skill compatible avec de nombreux coding agents ainsi qu’un serveur MCP permettant à ces agents d’interroger directement le graphe.
Fonctionnalités
- Knowledge graph de code : représentation structurée des fichiers, symboles, fonctions, classes et relations.
- Parsing AST local : Tree-sitter permet une extraction déterministe sans LLM pour le code.
- Relations explicites et inférées : distinction
EXTRACTED/INFERREDpermettant de suivre la provenance des informations. - Query / Path / Explain : recherche en langage naturel, chemin le plus court entre deux concepts et explication d’un nœud.
- Community detection : regroupement automatique du graphe en sous-systèmes avec Leiden.
- God nodes : identification des concepts les plus connectés du projet.
- Cross-file resolution : résolution des appels, imports, héritages et mixins à travers de nombreux langages.
- Documentation reliée au code : ADR, RFC, commentaires
# NOTE:/# WHY:et autres documents peuvent devenir des nœuds du graphe. - Support multi-source : code, Markdown, PDF, images, vidéo/audio et URLs peuvent être intégrés dans le corpus.
- MCP : accès au graphe directement depuis les agents.
- Mode watch / mise à jour incrémentale : possibilité de maintenir le graphe à jour lorsque les fichiers évoluent.
- Export graph : HTML, SVG, GraphML et intégrations Neo4j/FalkorDB.
- Génération de wiki / Obsidian : Graphify peut générer une base navigable à partir du graphe.
Analyse
| Critère | Note |
|---|---|
| Documentation | ★★★★☆ |
| Précision des descriptions | ★★★☆☆ |
| Richesse fonctionnelle | ★★★★★ |
| Pertinence pour les coding agents | ★★★★☆ |
| Qualité du modèle de connaissance | ★★★★☆ |
| Traçabilité des informations | ★★★★★ |
| Maturité | ★★☆☆☆ |
| Popularité | ★★★★★ |
| Stabilité de l’architecture | ★★★☆☆ |
| Intégration MCP | ★★★★★ |
Notes Documentation, Précision et Maturité alignées sur le barème global (10 octobre 2026). Popularité calculée depuis les étoiles du dépôt GitHub : 148 663 au 16 novembre 2026.
Commentaire : Graphify propose une architecture particulièrement intéressante pour les agents de développement : le graphe est persistant, interrogeable et conserve la provenance des relations. Le parsing du code est local et déterministe, tandis que les traitements sémantiques peuvent utiliser un LLM pour les documents et médias. Le projet est cependant en évolution très rapide : la branche active est v8, le dépôt compte plus de 1 800 commits et reste soumis à de nombreuses évolutions et corrections.
Points forts
- Approche différente du RAG vectoriel : le code est représenté comme un graphe de relations navigable plutôt que comme une collection de chunks et d’embeddings.
- Provenance des relations :
EXTRACTEDetINFERREDpermettent à l’agent de distinguer ce qui est explicitement présent dans les sources de ce qui a été déduit. - Très forte intégration avec les coding agents : Claude Code, Cursor, Codex, Gemini CLI, GitHub Copilot et de nombreuses autres plateformes sont supportées.
- Architecture local-first pour le code : le parsing AST n’utilise pas de LLM et les données du code peuvent rester sur la machine.
- MCP natif : le graphe devient une capacité externe réutilisable par différents agents et workflows.
- Pont entre code et documentation : les décisions d’architecture et la documentation peuvent être reliées directement aux composants concernés.
- Possibilité de transformer le graphe en base documentaire : les fonctions Wiki et Obsidian rendent l’approche intéressante au-delà du simple coding agent.
- Activité de contribution élevée : nombreuses pull requests en septembre 2026. Sa popularité mesure l’attention portée à un projet très récent ; les retours longs en production restent rares.
Limites
- Projet encore très mouvant : la branche
v8et le rythme élevé des changements indiquent une architecture qui continue d’évoluer rapidement. - Complexité croissante du graphe : sur de très gros projets, la quantité de relations peut rendre la navigation difficile malgré les mécanismes de communautés et de filtrage.
- Relations inférées à surveiller :
INFERREDne doit pas être considéré comme équivalent à une relation explicitement observée. - Traitement documentaire potentiellement dépendant d’un LLM : contrairement au parsing du code, l’analyse sémantique des documents et médias peut faire intervenir le modèle configuré.
- Problèmes potentiels en environnement collaboratif : des discussions du projet signalent notamment des difficultés liées à la génération et au partage de
graph.jsonentre plusieurs développeurs, ainsi qu’à la reproductibilité de certains artefacts. - Dette technique encore visible : certaines parties du code sont très volumineuses ; une issue identifie par exemple un
extract.pyde plus de 11 000 lignes regroupant de nombreux extracteurs de langages. - Complétude limitée par les langages dynamiques : une relation syntaxique ne représente pas toujours le comportement à l’exécution ; métaprogrammation, injection de dépendances et dépendances dynamiques échappent en partie au graphe. Graphify ne remplace ni un index sémantique ni l’observabilité runtime.
- Pertinence pour les coding agents non démontrée indépendamment : la note ★★★★☆ reflète l’intérêt de l’approche, pas une mesure du gain sur des tâches réelles. Des outils comme Sourcegraph ou CodeSee offrent une exploration plus intégrée et mature ; Serena et les indexeurs d’agents optimisent plutôt la récupération de contexte.
- Benchmarks à relativiser : les résultats publiés montrent un intérêt réel de l’approche, mais ils restent des benchmarks fournis par le projet et ne constituent pas une validation indépendante générale.
Relations
- Complémentaire de : RAG vectoriel classique et index sémantique (il apporte une vue structurelle déterministe, il ne les remplace pas)
- Alternative partielle à : Sourcegraph, CodeSee, Serena
- S’intègre avec : Claude Code, Cursor, OpenAI Codex, Gemini CLI, GitHub Copilot, MCP
- Utilise : Tree-sitter, Leiden, knowledge graphs
- Peut exporter vers : Neo4j, FalkorDB, Obsidian
- Se rapproche de : GraphRAG / code intelligence / repository indexing
Mémo pratique
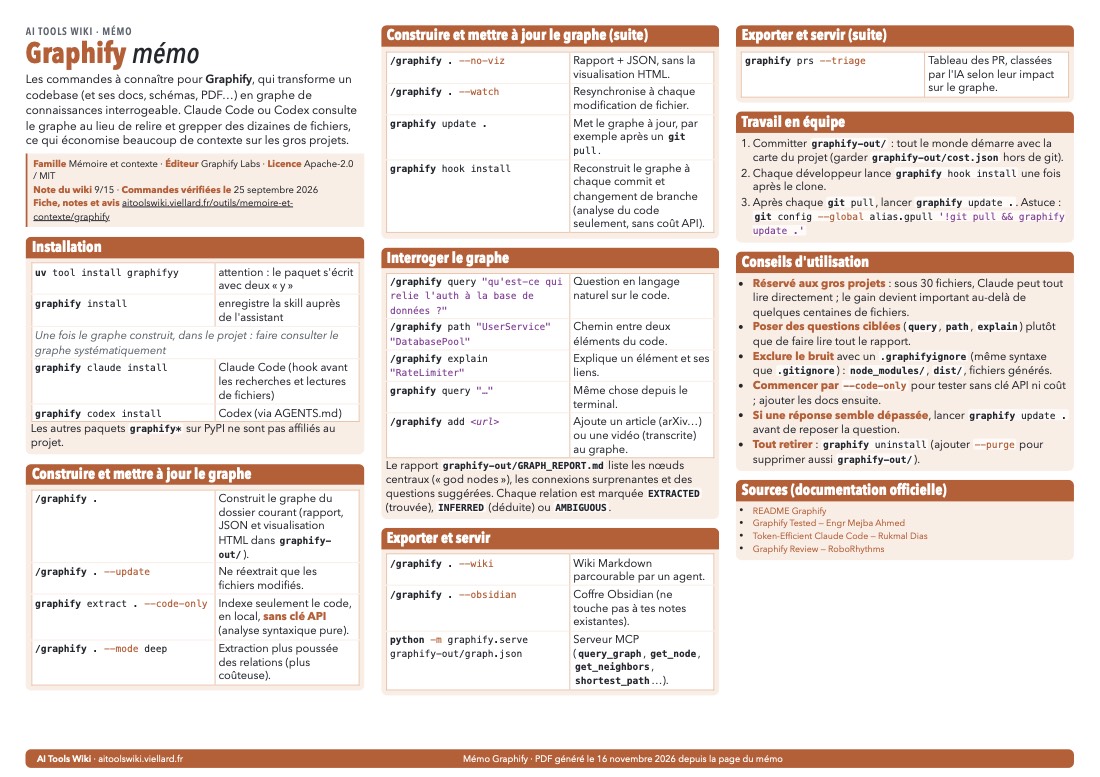
Télécharger le mémo en PDF (1 page A4 paysage, 201 Ko). Il est généré depuis la page du mémo, qui reste la version de référence : commandes à copier, recherche dans le site.
Avis indépendants
Synthèse des retours publiés, mise à jour le 24 septembre 2026.
Synthèse
Graphify attire par sa capacité à transformer rapidement un dépôt en graphe navigable, utile pour l’onboarding, l’exploration d’un monorepo et les revues d’architecture. Les sorties HTML et JSON parlent à la fois aux humains et aux agents, et l’analyse statique apporte une vue déterministe complémentaire aux résumés d’un LLM.
Le projet est très récent et les chiffres de popularité dépassent encore la quantité de retours longs en production. Un graphe riche peut devenir encombré sur de très gros dépôts, et une relation syntaxique ne représente pas toujours le comportement à l’exécution. Les langages, métaprogrammations et dépendances dynamiques limitent aussi la complétude. Il ne remplace ni un index sémantique ni l’observabilité runtime.
Comparaison
Sourcegraph et CodeSee offrent une exploration plus intégrée et mature ; Serena ou les indexeurs d’agents optimisent plutôt la récupération de contexte. Graphify se distingue comme outil batch open source produisant un artefact visuel et portable.
Verdict
Très prometteur pour cartographier et expliquer un codebase ; à valider sur ses langages réels et à combiner avec tests et traces d’exécution.
Sources
Sources des avis
Dernière analyse : 12 novembre 2026