Agent IA open source et auto-hébergeable de Nous Research, conçu pour fonctionner en continu, conserver une mémoire entre les sessions et transformer l’expérience acquise en compétences réutilisables. Il associe une CLI/TUI, des applications de bureau, une passerelle de messagerie, plus de 70 outils, des tâches planifiées, des sous-agents et un client MCP dans un même environnement.
Composition : 58 skills intégrées et 150 optionnelles dans le dépôt ; 1 agent principal et des sous-agents parallèles ; outils MCP selon les serveurs connectés (stdio, HTTP).
Voir aussi : la section Avis indépendants pour une synthèse des tests et opinions publiés par les utilisateurs, et Hermes Agent mémo pour le mémo pratique.
Mémo : Hermes Agent mémo pour les commandes à retenir.
Résumé
Hermes Agent est un agent harness Python développé par Nous Research : il fournit l’infrastructure complète autour d’un modèle de langage pour recevoir une demande, planifier, appeler des outils, mémoriser les résultats et poursuivre le travail à travers plusieurs sessions. Il se distingue ainsi d’un simple chatbot et d’un framework de briques à assembler. L’utilisateur peut lui parler depuis le terminal, l’application de bureau ou une passerelle reliée à Telegram, Discord, Slack, WhatsApp, Signal et l’e-mail ; les tâches récurrentes sont exécutées par un ordonnanceur cron intégré.
Son positionnement repose sur une « boucle d’apprentissage » fermée. Après une interaction, une revue en arrière-plan peut extraire un fait durable vers la mémoire ou créer et corriger une skill Markdown. Cette amélioration n’est toutefois pas un entraînement du modèle : elle repose sur des fichiers de mémoire, l’historique des sessions, des instructions et des compétences procédurales que le LLM choisit ensuite de consulter. Le résultat dépend donc fortement du modèle, de la configuration, des limites de contexte et de la qualité des workflows enseignés.
La mémoire est volontairement structurée et bornée. MEMORY.md conserve les faits sur les projets et l’environnement (2 200 caractères), tandis que USER.md retient les préférences utilisateur (1 375 caractères). Toutes les conversations sont parallèlement archivées dans SQLite et indexées par FTS5 pour une recherche à la demande. Des fournisseurs externes comme Honcho, Mem0, Hindsight, OpenViking ou Supermemory peuvent compléter ou remplacer cette mémoire locale.
Hermes n’impose pas de modèle unique. Il fonctionne avec Nous Portal, OpenRouter, OpenAI, Anthropic et des points de terminaison compatibles, y compris des modèles locaux. Le registre compte plus de 70 outils répartis dans 28 toolsets : terminal, fichiers, recherche web, navigation, vision, génération d’images, synthèse vocale, mémoire, cron, délégation, Home Assistant et outils MCP dynamiques. Les commandes peuvent s’exécuter localement ou dans sept backends : Docker, SSH, Singularity, Modal, Daytona, Vercel Sandbox et la machine hôte.
Fonctionnalités
-
Mémoire persistante multicouche : fichiers
MEMORY.mdetUSER.mdinjectés au début d’une session, historique SQLite avec recherche plein texte FTS5 et fournisseurs de mémoire externes facultatifs. -
Boucle d’amélioration en arrière-plan : analyse des conversations terminées pour proposer ou appliquer des ajouts à la mémoire et des créations ou corrections de skills. Les écritures peuvent être soumises à approbation avec
memory.write_approvaletskills.write_approval. -
Skills compatibles agentskills.io : 58 skills intégrées et 150 optionnelles présentes dans le dépôt au 25 septembre 2026, auxquelles s’ajoutent le Skills Hub, les skills de projet et celles créées par l’agent. Le chargement progressif évite d’injecter leur contenu complet avant qu’il soit nécessaire.
-
Plus de 70 outils et 28 toolsets : terminal, édition de fichiers, recherche et extraction web, navigateur texte/vision, image, audio, mémoire, recherche de sessions, code Python, tâches, délégation, domotique et intégrations tierces.
-
Client MCP natif : connexion à des serveurs locaux en stdio ou distants en HTTP/SSE, filtrage des outils, chargement paresseux, cache des schémas, recyclage des processus lourds et préfixage des noms pour éviter les collisions.
-
Délégation à des sous-agents : création de conversations isolées pour traiter des axes en parallèle, avec un contexte explicitement transmis par le parent. Des scripts Python peuvent aussi enchaîner les outils via RPC afin de réduire le coût de contexte des pipelines répétitifs.
-
Automatisations cron : tâches ponctuelles ou récurrentes décrites en langage naturel, exécutées sans session interactive et livrées sur les plateformes de messagerie configurées.
-
Interfaces multiples : CLI, TUI, application Hermes Desktop, tableau de bord web, API, ACP pour les IDE et passerelle de messagerie. Les conversations peuvent être reprises entre plusieurs surfaces.
-
Compatibilité multi-modèles : choix et changement de fournisseur sans modifier le code. Nous Portal regroupe en option modèles et services hébergés, mais les clés et fournisseurs personnels restent utilisables séparément.
-
Sept environnements d’exécution : local, Docker, SSH, Singularity/Apptainer, Modal, Daytona et Vercel Sandbox, du poste personnel au cluster GPU ou au conteneur à la demande.
-
Personnalisation par profils et fichiers de contexte : profils séparés avec leur propre mémoire, leurs sessions, skills, outils et tâches ; comportement configurable via
SOUL.md,AGENTS.mdet les réglages de plateforme. -
Migration depuis OpenClaw : import guidé des paramètres, mémoires, skills, clés autorisées, plateformes de messagerie, règles d’approbation et fichiers de personnalité, avec mode
--dry-run. -
Sécurité en profondeur : appairage et listes d’utilisateurs, approbation des commandes dangereuses, racine d’écriture optionnelle, isolation par conteneur, filtrage des variables MCP, analyse des fichiers de contexte et des skills, séparation des sessions et validation des chemins.
-
Fonctions de recherche : exécution par lots, sauvegarde et compression de trajectoires pour produire des jeux de données destinés à l’évaluation ou à l’entraînement de modèles appelant des outils.
Analyse
| Critère | Note |
|---|---|
| Documentation | ★★★★★ |
| Précision des descriptions | ★★★☆☆ |
| Maturité | ★★★☆☆ |
| Popularité | ★★★★★ |
Notes Documentation, Précision et Maturité alignées sur le barème global (10 octobre 2026). Popularité calculée depuis les étoiles du dépôt GitHub : 263 766 au 16 novembre 2026.
Points forts
-
Architecture cohérente de bout en bout : mémoire, skills, outils, messagerie, cron, délégation et déploiement sont intégrés dans un seul produit au lieu de demander l’assemblage de nombreux composants.
-
Mémoire explicite et vérifiable : les connaissances durables restent dans des fichiers Markdown lisibles, tandis que l’historique complet est interrogeable dans SQLite. L’utilisateur peut donc inspecter, corriger ou supprimer ce qui a été appris.
-
Skills portables et économes en contexte : compatibilité agentskills.io, chargement progressif, skills locales ou propres au projet, catalogue optionnel et création guidée avec
/learn. -
Grande liberté d’infrastructure et de modèles : aucun fournisseur de LLM n’est obligatoire ; l’agent peut tourner localement, sur un VPS, dans Docker, sur un serveur SSH, un cluster HPC ou un backend serverless.
-
Bon socle pour les workflows persistants : tâches planifiées, messagerie et continuité intersession conviennent à la veille, aux rapports, à l’administration d’un homelab, au développement et à la recherche de longue durée.
-
Documentation technique très approfondie : architecture, assemblage du prompt, compression du contexte, sécurité, outils, mémoire et développement de plugins sont documentés au niveau de l’implémentation.
-
Rythme de développement soutenu : version stable v0.21.5 publiée le 24 septembre 2026 et environ 3 963 contributeurs. Sa popularité mesure l’attention portée au projet, pas la fiabilité de l’agent : les retours indépendants restent des témoignages, avec peu de benchmarks contrôlés.
Limites
-
« Auto-amélioration » non déterministe : Hermes écrit des souvenirs et des procédures, mais ne réentraîne pas le modèle. Un LLM peut oublier d’appeler l’outil de mémoire, produire une mauvaise skill ou ignorer une règle ; les petits modèles et les configurations complexes amplifient ce problème.
-
Coût en jetons et latence : le prompt de base, l’index des skills, les appels d’outils, la compression et la revue en arrière-plan s’ajoutent à chaque workflow. Cette revue peut être désactivée, plafonnée ou confiée à un modèle moins cher, mais nécessite un réglage conscient.
-
Administration technique réelle : l’auto-hébergement implique mises à jour, sauvegardes, supervision du gateway, gestion des clés, choix du backend, limites de ressources et diagnostic des fournisseurs. Ce n’est pas un assistant grand public sans maintenance.
-
Surface d’attaque importante : un agent persistant doté d’un terminal, d’une mémoire, de clés API et d’accès à la messagerie reste une cible sensible malgré les huit couches de protection documentées. L’exécution locale non isolée ou le mode
--yolodonnent au modèle des capacités très larges. -
Mémoire dépendante de bonnes frontières de session : une conversation de messagerie peut rester ouverte des semaines, augmenter les coûts de compression et retarder la prise en compte des nouveaux souvenirs. La documentation recommande
/newaux changements naturels de tâche ou de journée. -
Évolution très rapide : l’étendue du dépôt, les milliers de contributions et les changements fréquents rendent le suivi des régressions et des nouveaux réglages difficile. Les fonctions récentes exigent des tests avant une utilisation critique.
-
Automatisation web imparfaite : comme les autres agents pilotant un navigateur, Hermes reste exposé aux CAPTCHA, aux protections anti-bot et aux changements d’interface. Une API ou un outil spécialisé est souvent plus fiable pour une tâche répétitive.
-
Historique de sécurité public : une note de la Cloud Security Alliance (mai 2026) recensait trois CVE affectant d’anciennes versions, et une étude académique de juillet 2026 (MemGhost, prépublication) montre qu’une injection indirecte peut empoisonner durablement la mémoire de plusieurs agents personnels, dont Hermes. Les garde-fous documentés réduisent le risque sans l’éliminer ; l’exécution dans un sandbox reste recommandée.
-
Transparence des intégrations par défaut : en juin 2026, la recherche web « sans clé » passait automatiquement par un service tiers (Parallel.ai) après une modification récente ; le fallback a été retiré après signalement. « Sans clé » ne signifie pas « local » : vérifier les fournisseurs réellement appelés après chaque mise à jour.
-
Controverse de provenance : des discussions publiques ont accusé certaines fonctions d’auto-amélioration d’être inspirées d’un autre projet sans attribution suffisante. Les sources disponibles ne permettent pas de trancher ; les organisations sensibles à l’origine du code devraient examiner l’historique elles-mêmes.
-
Coût en jetons mesuré sur un seul test : un comparatif personnel non reproductible rapporte 73,5 millions de jetons consommés en une journée contre 42 millions pour OpenClaw ; l’ordre de grandeur est cohérent avec le mécanisme de revue en arrière-plan, mais il reste à confirmer sur ses propres usages.
Qualité
Commentaire : Hermes Agent dispose d’une documentation, d’une architecture et d’une couverture fonctionnelle remarquables pour un projet aussi jeune. Le mécanisme d’apprentissage est mieux compris comme une couche de mémoire procédurale auditable que comme une intelligence qui se réentraîne seule. La précision des descriptions est notée ★★★☆☆ : la promesse d’un agent qui « grandit avec vous » dépasse ce que les retours indépendants confirment (résultats irréguliers selon le modèle et la configuration), et les présentations tendent à minimiser la maintenance à assurer. La maturité est intermédiaire (★★★☆☆ : projet jeune en v0.x, CVE historiques) et reste en retrait de l’ambition affichée, et l’accès persistant aux outils demande un durcissement sérieux.
Relations
-
Alternative à : OpenClaw, NanoClaw, OpenCode pour certains workflows agentiques
-
Complémentaire de : Paperclip comme agent exécutant au sein d’une orchestration multi-agents ; Claude Code ou OpenAI Codex comme agents spécialisés auxquels déléguer du code
-
S’intègre avec : Telegram, Discord, Slack, WhatsApp, Signal, e-mail, Home Assistant, tout serveur MCP, Nous Portal, OpenRouter, OpenAI, Anthropic, Ollama et autres endpoints compatibles
-
Utilise : Python 3.11, SQLite/FTS5, fichiers Markdown
SKILL.md, Model Context Protocol, Docker et backends d’exécution optionnels
Mémo pratique
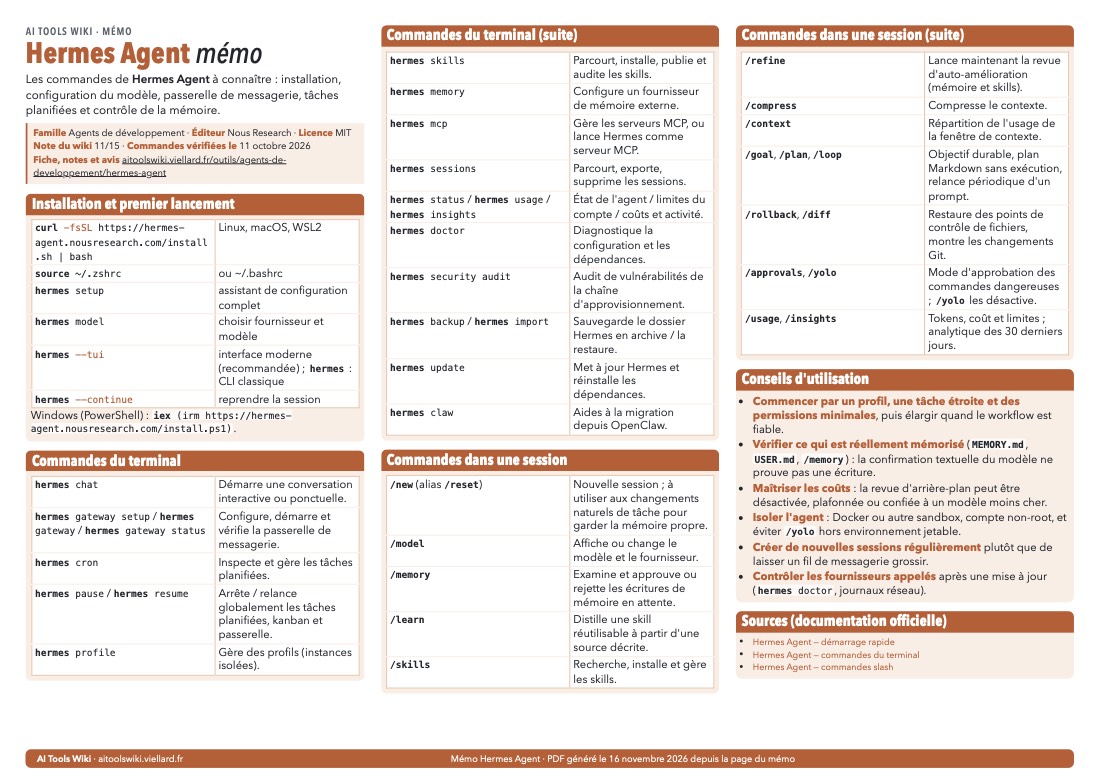
Télécharger le mémo en PDF (1 page A4 paysage, 172 Ko). Il est généré depuis la page du mémo, qui reste la version de référence : commandes à copier, recherche dans le site.
Avis indépendants
Synthèse des tests, discussions et critiques publiques sur Hermes Agent. Relevé le 25 septembre 2026.
En bref
| Aspect | Tendance des retours |
|---|---|
| Mémoire entre les sessions | Positive, principal différenciateur |
| Création et amélioration des skills | Prometteuse mais irrégulière |
| Orchestration et automatisation | Très positive chez les utilisateurs techniques |
| Choix des modèles et déploiements | Très positive |
| Prise en main | Mitigée : installation simple, configuration exigeante |
| Vitesse et consommation de jetons | Mitigée à négative |
| Interface par défaut | Mitigée |
| Sécurité et confidentialité | Prudence forte, sandbox recommandée |
| Recul critique disponible | Moyen : nombreux témoignages, peu de benchmarks contrôlés |
L’opinion générale est favorable chez les utilisateurs techniques qui cherchent un agent persistant à façonner dans le temps. La mémoire intersession, les profils, les skills et la délégation sont les points les plus appréciés. Les critiques portent moins sur le nombre de fonctions que sur leur coût opérationnel : beaucoup de réglages, davantage de jetons qu’un agent plus minimal, une latence parfois élevée et une amélioration automatique qui dépend du modèle et de la configuration.
La formule « agent qui grandit avec vous » est donc crédible comme mémoire procédurale — Hermes écrit et réutilise des fichiers — mais ne doit pas être interprétée comme un apprentissage garanti ou un réentraînement autonome du LLM.
Ce qui est apprécié
La continuité entre les sessions
C’est le retour positif le plus constant. Dans un test comparatif d’une journée, un utilisateur juge Hermes nettement meilleur qu’OpenClaw pour reprendre un travail dans une nouvelle conversation, même s’il se dégrade plus vite dans une conversation très longue. Sur Hacker News, un utilisateur décrit un déploiement de homelab qui vérifie Kubernetes en lecture seule, demande une approbation avant les corrections SSH et envoie chaque matin un état des sauvegardes et des pods. Un autre explique avoir relié Hermes à une instance Matrix et à un modèle local pour remplacer plusieurs applications mobiles.
Ces cas correspondent bien à l’architecture du produit : mémoire courte injectée au démarrage, historique FTS5 consulté à la demande, passerelle toujours active et tâches cron. La continuité fonctionne mieux lorsque l’utilisateur crée régulièrement de nouvelles sessions, au lieu de laisser un fil de messagerie grossir indéfiniment.
Les skills et l’orchestration
Les utilisateurs avancés apprécient la capacité à transformer un processus corrigé en skill réutilisable, à séparer plusieurs profils et à déléguer du travail à des sous-agents. Le test Hermes/OpenClaw cité plus haut observe que Hermes crée davantage de skills et repère mieux les motifs répétitifs en arrière-plan. Son auteur le préfère finalement pour l’orchestration et sa communauté, malgré un coût en jetons supérieur.
Un retour détaillé après un mois conseille de ne pas construire immédiatement un assistant universel. L’approche jugée la plus fiable consiste à commencer par un workflow étroit, le stabiliser, puis créer des profils distincts pour le code, la recherche, la rédaction ou l’automatisation. Dans ce cadre, la configuration n’est pas une formalité : elle devient une partie du produit que l’utilisateur construit.
La liberté de choisir le modèle et l’infrastructure
Le support de nombreux fournisseurs, des modèles locaux et de plusieurs backends d’exécution est régulièrement cité comme un avantage. Hermes peut servir de couche stable au-dessus de modèles moins chers, puis basculer vers un modèle coûteux pour les tâches difficiles. Les profils et les toolsets permettent aussi de réduire ce qui est chargé pour chaque rôle.
Cette liberté reste conditionnelle : les modèles faibles en appel d’outils peuvent affirmer avoir mémorisé une information sans appeler réellement l’outil. La documentation officielle recommande alors de vérifier les fichiers et d’utiliser un modèle plus robuste au moins pour la configuration initiale.
La richesse fonctionnelle prête à l’emploi
CLI/TUI, applications de bureau, messagerie, cron, outils web, fichiers, terminal, MCP, mémoire, sous-agents et migration OpenClaw sont réunis dans le même projet. Plusieurs critiques externes estiment qu’Hermes est plus proche d’un environnement agentique complet que d’un simple chatbot ou d’un framework RAG. Pour un développeur ou un administrateur système, cette intégration évite de reconstruire tout le socle.
Ce qui est critiqué
Une auto-amélioration dépendante du modèle et des réglages
Les retours sont partagés sur la fonction phare. Certains utilisateurs observent bien la création et la mise à jour automatique des skills. D’autres rapportent qu’après plusieurs mois, Hermes continue à répéter les mêmes erreurs, ignore des outils MCP préférés ou n’enregistre pas les échecs dans sa mémoire.
Un fil Reddit documente notamment une incompatibilité de configuration entre un fournisseur de mémoire externe et la revue d’arrière-plan d’une version donnée : désactiver la mémoire native pouvait empêcher la revue automatique de se déclencher. Les réponses montrent toutefois des installations où la même combinaison fonctionne correctement avec un autre SOUL.md et un autre modèle. Ce contraste résume bien l’état du produit : la boucle existe, mais son résultat n’est ni uniforme ni garanti.
La documentation officielle elle-même précise qu’une confirmation textuelle du modèle ne prouve pas qu’une écriture en mémoire a eu lieu. Il faut vérifier MEMORY.md, USER.md ou les écritures en attente, et activer l’approbation si l’on ne veut pas que des hypothèses soient enregistrées automatiquement.
Lenteur et consommation de jetons
Plusieurs utilisateurs décrivent un démarrage lent ou une réponse longue à une demande triviale. Sur Hacker News, un testeur qualifie Hermes de lent et surdimensionné par rapport à des CLI plus minimales. Un cas Reddit montre un « bonjour » envoyant environ 11 700 jetons au fournisseur et attendant plus d’une minute ; dans ce cas, la latence venait aussi du modèle distant et possiblement d’appels réseau bloqués, ce qui empêche d’attribuer toute la lenteur au harness.
Le comparatif Hermes/OpenClaw le plus chiffré rapporte 73,5 millions de jetons consommés par Hermes contre 42 millions par OpenClaw sur la journée, réduits respectivement à environ 53 et 42 millions après prise en compte du cache. Il s’agit d’un test personnel, non reproductible et utilisant plusieurs modèles, mais il confirme le mécanisme attendu : revue d’arrière-plan, création de skills, compression, sous-agents et outils peuvent multiplier les entrées.
La documentation permet maintenant de désactiver la revue automatique, de plafonner ses jetons ou de la router vers un modèle auxiliaire moins cher. Ces réglages réduisent le coût, au prix d’une boucle d’amélioration moins active.
Une prise en main facile, une exploitation exigeante
L’installation en une commande donne rapidement une première conversation, mais un agent utile sur la durée demande des choix : modèle, toolsets, profils, mémoire, fournisseurs web, backend terminal, secrets, messagerie, cron et règles d’approbation. Des utilisateurs enthousiastes recommandent de commencer par une seule tâche « ennuyeusement fiable » ; d’autres trouvent la gestion des profils trop tatillonne.
Les articles de présentation ont tendance à minimiser cette maintenance. L’utilisateur auto-hébergé reste responsable des mises à jour, des sauvegardes, du gateway, des journaux, des clés API et du coût des modèles. Hermes est plus adapté à quelqu’un qui accepte d’administrer une petite infrastructure qu’à une personne cherchant un assistant grand public sans réglages.
Sécurité : de bons garde-fous, mais une classe de produit risquée
Hermes documente huit couches de protection : autorisation des utilisateurs, approbation des commandes, restrictions d’écriture, conteneurs, filtrage des secrets MCP, détection d’injection dans les fichiers de contexte, isolation des sessions et validation des entrées. C’est plus explicite que dans beaucoup de projets concurrents.
Cela ne supprime pas le risque architectural. Une note de la Cloud Security Alliance recensait en mai 2026 trois CVE publiques affectant d’anciennes versions et recommandait isolation, moindre privilège et supervision. Une étude académique de juillet 2026 montre par ailleurs que l’injection indirecte peut empoisonner durablement la mémoire de plusieurs agents personnels, dont Hermes. La version testée de Hermes résistait mieux à la dissimulation complète que certains autres environnements, mais restait vulnérable à l’adoption et à l’utilisation ultérieure d’une fausse mémoire.
La recommandation communautaire la plus raisonnable est constante : exécuter l’agent dans Docker ou un autre sandbox, utiliser un compte non-root, limiter les répertoires et identifiants accessibles, conserver les validations humaines et éviter --yolo hors d’un environnement jetable.
Transparence des intégrations
En juin 2026, un utilisateur a découvert que la recherche web sans clé passait automatiquement par le service Parallel.ai après une modification récente. La relation professionnelle de l’auteur de la contribution n’était pas visible dans la configuration et le changement avait été fusionné rapidement. Après la discussion, le projet a supprimé ce fallback automatique dans la PR #46350.
L’incident a été corrigé, mais il illustre un point important pour un agent auto-hébergé : « sans clé » ne signifie pas « local ». Les opérateurs doivent vérifier les fournisseurs réellement appelés, les journaux réseau et les changements de valeurs par défaut après une mise à jour.
Navigation web et protections anti-bot
Les retours sur l’automatisation de sites sont mitigés. Des utilisateurs parviennent à surveiller des annonces ou à produire des rapports, mais Playwright et les navigateurs pilotés sont régulièrement bloqués par Cloudflare ou les protections anti-scraping. Pour les processus répétitifs, une API, un MCP spécialisé ou une source structurée consomme moins de jetons et se révèle généralement plus fiable.
Controverse autour de l’attribution
Des discussions Hacker News et plusieurs issues GitHub ont accusé certaines fonctions d’auto-amélioration d’être fortement inspirées du projet Evolver sans attribution suffisante. Les critiques portent aussi sur la modification du titre et du texte d’une issue ainsi que sur la suppression de commentaires. Les sources disponibles ne permettent pas de trancher juridiquement l’accusation de plagiat ; il s’agit donc d’une controverse de gouvernance et de provenance, pas d’un défaut fonctionnel démontré. Les organisations sensibles à l’origine du code devraient examiner l’historique et les échanges elles-mêmes avant adoption.
Comparaison
Face à OpenClaw
Les témoignages convergent vers un compromis plutôt que vers un gagnant absolu :
-
Hermes est généralement préféré pour la reprise entre sessions, la création de skills, l’orchestration de sous-agents, la profondeur de la documentation et le choix des backends.
-
OpenClaw est souvent jugé plus sobre en jetons et plus direct pour un large écosystème d’intégrations, avec davantage de recul historique. Certains utilisateurs le trouvent toutefois plus fragile lors des mises à jour.
-
Dans les longues conversations, un testeur voit Hermes se dégrader plus tôt ; dans une nouvelle conversation, le même testeur le trouve nettement meilleur pour retrouver le contexte pertinent.
Face à Claude Code, Codex et OpenCode
Ces outils sont d’abord des agents de développement interactifs. Hermes vise un rôle plus général et persistant : messagerie, cron, mémoire personnelle, outils système et coordination. Pour le code pur, plusieurs utilisateurs continuent à préférer Claude Code, OpenAI Codex ou OpenCode, quitte à les appeler depuis Hermes comme agents spécialisés.
Face à un workflow déterministe
Hermes convient lorsque le chemin doit s’adapter à l’imprévu. Pour une suite d’actions stable et critique, un script, un outil CI ou un workflow n8n reste plus prévisible, moins coûteux et plus facile à auditer. Le meilleur usage consiste souvent à laisser Hermes décider et préparer, puis à confier l’exécution répétitive à une automatisation déterministe.
Verdict
Hermes Agent est l’un des choix open source les plus complets pour construire un assistant persistant et auto-hébergé. Il est particulièrement convaincant pour un développeur, un chercheur ou un administrateur système qui veut conserver le contrôle des modèles, des outils et des données, et qui accepte d’affiner son installation dans la durée.
Il est moins convaincant comme assistant « prêt à l’emploi » : il faut surveiller ce qu’il mémorise, maîtriser les coûts de la revue d’arrière-plan, créer de bonnes frontières de session et isoler strictement ses accès. Pour un premier déploiement, le meilleur conseil issu des retours est simple : un profil, une tâche étroite, des permissions minimales et des validations humaines. Élargir ensuite seulement lorsque le workflow est devenu fiable.
Sources
-
Hostinger — Qu’est-ce que Hermes Agent ? (tutoriel d’un hébergeur, non indépendant)
-
Cloud Security Alliance — note de sécurité sur les CVE de Hermes Agent (mai 2026)
-
Étude MemGhost sur l’injection de mémoire (arXiv, juillet 2026)
Sources des avis
| Source | Date | Nature | Fiabilité |
|---|---|---|---|
| Hacker News — discussion générale | juin 2026 | Retours positifs et critiques de plusieurs utilisateurs | Moyenne |
| Reddit — un mois avec Hermes | mai 2026 | Retour détaillé d’un utilisateur et discussion sur les profils | Moyenne |
| Reddit — test Hermes/OpenClaw | juillet 2026 | Comparaison directe avec chiffres de jetons | Moyenne, test non contrôlé |
| Reddit — l’auto-amélioration fonctionne-t-elle ? | juillet 2026 | Retours contradictoires et diagnostic technique | Moyenne |
| Reddit — lenteur de l’agent | avril 2026 | Diagnostic d’une latence élevée | Moyenne |
| Reddit — fallback Parallel.ai | juin 2026 | Signalement documenté, réponse du projet et correctif | Élevée pour l’incident, moyenne pour les interprétations |
| Analyse de l’architecture par Luis Mori | 3 juillet 2026 | Analyse technique sourcée et nuancée | Élevée |
| Eesel — test de Hermes Agent | 19 juillet 2026 | Test externe, comparatif et synthèse de témoignages | Moyenne à élevée |
| Cloud Security Alliance — note de sécurité | mai 2026 | Synthèse des CVE et recommandations de durcissement | Élevée, mais photographie datée |
| Étude MemGhost sur l’injection de mémoire | 6 juillet 2026 | Prépublication académique avec tests sur Hermes | Élevée pour le protocole publié, non évaluée par les pairs |
| Hacker News — controverse d’attribution | mai 2026 | Discussion d’allégations et de modération d’issues | Faible à moyenne ; accusation non tranchée |
| Documentation officielle — mémoire | septembre 2026 | Comportement, limites et réglages officiels | Élevée pour le fonctionnement, non indépendante |
| Documentation officielle — sécurité | septembre 2026 | Garde-fous et recommandations de déploiement | Élevée pour le fonctionnement, non indépendante |
Dernière analyse : 12 novembre 2026