Agent Skill open source qui repère 25 habitudes fréquentes des textes générés par IA, puis réécrit la prose pour la rendre plus directe et plus proche de la voix de son auteur, sans modifier les faits fournis.
Voir aussi : la section Avis indépendants pour une synthèse des retours et réserves, et Humanizer mémo pour le mémo pratique.
Résumé
Humanizer, développé par Siqi Chen (blader), est une skill distribuée sous la forme d’un fichier SKILL.md. Elle n’embarque ni modèle, ni API, ni moteur de détection : elle fournit à un agent existant une méthode de révision éditoriale fondée sur la page Wikipédia « Signs of AI writing ».
La version 3.0.0 regroupe 25 schémas rédactionnels dans cinq familles : mise en scène avant le propos, rythme appliqué mécaniquement, inflation du langage et autorité vague, formatage automatique, puis résidus de conversation ou de brouillon. Les cinq premiers signaux peuvent justifier une correction isolée ; les signaux faibles, tels que les tirets ou la voix passive, ne sont corrigés que lorsqu’ils s’accumulent ou contredisent la voix fournie.
Humanizer analyse le texte, produit un premier brouillon, contrôle les faits et les motifs qui subsistent, puis rédige une version finale. Avec un échantillon de deux ou trois paragraphes, il tente de reprendre le rythme, le vocabulaire, la ponctuation et les choix stylistiques de l’utilisateur.
Fonctionnalités
-
25 motifs explicites et inspectables : constructions « pas X mais Y », conclusions dramatiques, aphorismes artificiels, introductions creuses, objections inventées, triades forcées, mots surutilisés, emphase promotionnelle, formatage décoratif et résidus de chatbot.
-
Hiérarchie des signaux : séparation entre indices forts et indices faibles afin de limiter les corrections trop mécaniques et les faux positifs.
-
Réécriture en plusieurs passes : repérage, brouillon, vérification des faits et des motifs restants, puis version finale.
-
Préservation des informations : les noms, dates, chiffres, citations et affirmations doivent venir du texte source ou de l’utilisateur ; la skill demande un détail manquant au lieu de l’inventer.
-
Adaptation à la voix : un échantillon peut servir de référence pour la longueur des phrases, le choix des mots, la ponctuation et les particularités volontaires.
-
Trois modes de sortie : texte collé avec analyse intermédiaire, modification directe d’un fichier, ou mode embarqué qui ne renvoie que la version finale.
-
Protection des fichiers structurés : en mode fichier, les blocs de code, commandes, chemins, métadonnées YAML, données et cibles de liens doivent rester inchangés.
-
Installation portable : Skills CLI pour les agents compatibles, plugin Claude Code, ZIP pour Claude Desktop ou copie manuelle du
SKILL.md.
Analyse
| Critère | Note |
|---|---|
| Documentation | ★★★★☆ |
| Précision des descriptions | ★★★★☆ |
| Clarté des règles | ★★★★★ |
| Portabilité | ★★★★★ |
| Respect des faits | ★★★☆☆ |
| Adaptation à la voix | ★★★☆☆ |
| Validation indépendante | ★★★☆☆ |
| Prise en charge multilingue | ★★★☆☆ |
| Maturité | ★★★☆☆ |
| Popularité | ★★★★☆ |
Notes Documentation, Précision et Maturité alignées sur le barème global (10 octobre 2026). Popularité calculée depuis les étoiles du dépôt GitHub : 69 658 au 16 novembre 2026.
Points forts
-
Méthode transparente : chaque correction correspond à une règle lisible, illustrée et modifiable, contrairement aux services de réécriture opaques.
-
Très faible complexité technique : un fichier Markdown suffit ; aucune clé API ou infrastructure supplémentaire n’est imposée par le projet.
-
Discipline factuelle prévue par la méthode : la version actuelle traite l’ajout d’une affirmation et la perte d’une information comme des erreurs à contrôler ; l’efficacité observée repose sur un essai public limité à un cas facile.
-
Voix personnelle prioritaire : les exemples fournis par l’utilisateur peuvent outrepasser certaines règles, ce qui évite d’uniformiser tous les textes vers un style unique.
-
Projet actif : la version 3.0.0, publiée le 6 septembre 2026, simplifie l’ancienne liste de 35 motifs en 25 règles mieux hiérarchisées (la popularité du dépôt n’est pas une mesure de qualité).
Limites
-
Dépend du modèle hôte : Humanizer est un ensemble d’instructions. Sa qualité, son coût et sa vitesse dépendent entièrement de l’agent qui l’exécute.
-
Ne contourne pas les détecteurs d’IA : le mainteneur précise que cet objectif ne fait pas partie du projet. Un test public a mesuré une préférence de lecture nette sans amélioration significative du score de détection.
-
Risque de normalisation : retirer les indices lexicaux peut produire une prose propre mais encore trop régulière, complète ou explicative. Un retour signale notamment ce problème dans les commentaires de pull request et les messages courts.
-
Socle surtout anglophone : la liste, les exemples et la source Wikipédia visent principalement l’anglais. Les habitudes rédactionnelles varient selon les langues et demandent des adaptations locales.
-
Pas de benchmark officiel continu : la CI valide le package, mais le dépôt ne fournit pas de corpus stable mesurant la qualité, la conservation du sens ou les faux positifs à chaque version.
-
Preuves indépendantes limitées : une comparaison à l’aveugle partagée dans les issues GitHub a préféré la version révisée dans 16 cas sur 16, mais les juges provenaient d’une seule famille de modèles, seuls 77 des 144 essais prévus ont abouti et l’expérience n’a pas été revue par les pairs ; le score de détection est resté pratiquement inchangé. L’adaptation à la voix n’a pas été testée dans l’essai le plus cité.
-
Un bon style ne garantit pas un bon contenu : la skill ne vérifie ni les sources, ni la logique de fond, ni l’originalité intellectuelle du texte.
Qualité
Commentaire : Humanizer est surtout utile comme grille de révision et comme deuxième passe sur un brouillon. Sa force vient de règles visibles, d’une vraie attention aux faits et de la possibilité de fournir sa propre voix. Il faut toutefois juger le résultat à la lecture et non au score d’un détecteur, puis vérifier que la réécriture n’a supprimé aucune nuance importante.
Relations
-
Alternative à : Stop Slop, Orwell Writing, Avoid AI Writing
-
S’intègre avec : Claude Code, Claude Desktop, OpenAI Codex, Cursor et les agents compatibles avec Agent Skills
-
Utilise : format
SKILL.md, Skills CLI, Wikipedia: Signs of AI writing
Mémo pratique
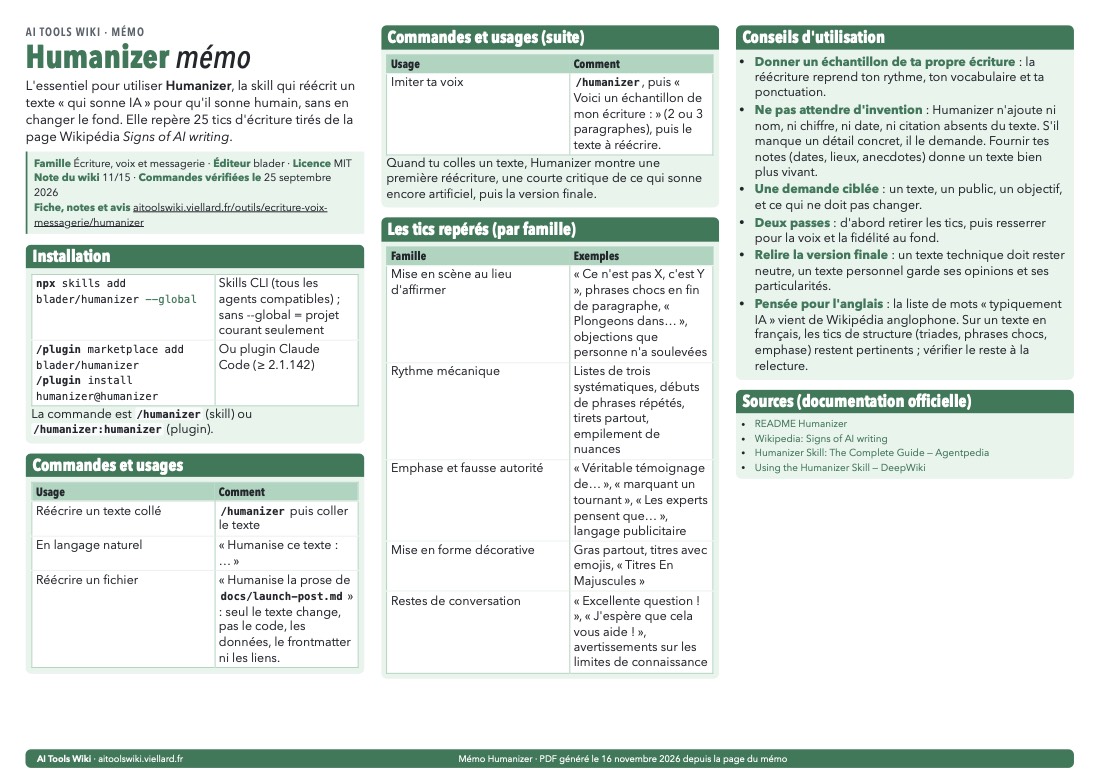
Télécharger le mémo en PDF (1 page A4 paysage, 156 Ko). Il est généré depuis la page du mémo, qui reste la version de référence : commandes à copier, recherche dans le site.
Avis indépendants
Synthèse des retours publiés, mise à jour le 24 septembre 2026.
Synthèse
Les retours les plus solides décrivent Humanizer comme un outil de révision, pas comme un dispositif capable de prouver qu’un humain a écrit le texte. Son intérêt vient de la liste visible des motifs, du processus brouillon–contrôle–réécriture et de la conservation explicite des faits. Des utilisateurs apprécient également la possibilité de fournir un échantillon de leur propre voix au lieu d’accepter un style « naturel » générique.
Un essai publié par StashBase montre un résultat concret mais limité : sur un court texte marketing volontairement caricatural, la skill a supprimé les tirets, triades et formulations promotionnelles tout en conservant les deux faits principaux. L’auteur précise qu’il s’agit d’un seul cas facile et que l’adaptation à la voix n’a pas été testée.
Le retour quantitatif le plus intéressant vient d’une expérience communautaire partagée dans les issues GitHub. Lors d’une comparaison à l’aveugle, la passe Humanizer a été préférée au texte brut dans 16 cas sur 16. En revanche, le score de détection n’a pratiquement pas bougé : 100 %, puis 98,6 % après réécriture. L’essai rapporte aussi la disparition des tics lexicaux et typographiques, mais une hausse de certains rythmes réguliers et des conclusions aphoristiques. Ces résultats ne sont pas revus par les pairs : les juges provenaient d’une seule famille de modèles et seuls 77 des 144 essais prévus ont abouti. Le mainteneur confirme que contourner les détecteurs n’est pas l’objectif du dépôt.
Ce que les utilisateurs apprécient
- Les règles sont visibles, argumentées et faciles à adapter.
- La réécriture réduit efficacement le vocabulaire pompeux, les introductions creuses, les triades et le formatage décoratif.
- Le texte obtenu est souvent plus court, plus direct et jugé plus agréable à lire.
- Le mode fichier protège le code, les métadonnées et les liens tout en révisant la prose.
- L’installation est légère et fonctionne avec plusieurs agents compatibles avec les skills.
- Plusieurs retours recommandent l’outil pour les documents destinés à des clients, à condition de conserver une relecture humaine.
Critiques récurrentes
- Confusion autour du mot “humanizer” : certains utilisateurs attendent un contournement de GPTZero, Pangram ou Turnitin, alors que le projet ne le promet pas. Les témoignages sont contradictoires et les scores de détecteurs restent peu fiables.
- Rythme encore artificiel : la suppression des mots et signes les plus visibles peut laisser une structure trop régulière ou trop bien organisée.
- Texte trop complet pour le contexte : un retour sur un commentaire de pull request montre que la skill peut conserver toute l’explication alors qu’un humain s’appuierait sur le contexte partagé et répondrait plus brièvement.
- Résultats liés au modèle : la même instruction peut produire des sorties différentes selon l’agent, la version du modèle et le prompt qui l’entoure.
- Langues autres que l’anglais : des contributeurs demandent des variantes adaptées, car les indices stylistiques du néerlandais, du tchèque ou du français ne sont pas les mêmes.
- Risque de faux positifs stylistiques : tirets, répétitions, voix passive ou groupes de trois peuvent être des choix humains volontaires. La version 3.0.0 ajoute des garde-fous, mais la relecture reste nécessaire.
Comparaison
Les services commerciaux de “humanisation” proposent une interface prête à l’emploi et promettent parfois de meilleurs scores face aux détecteurs, mais leur méthode est généralement opaque. Humanizer privilégie l’inspection : la règle, le texte source et la réécriture restent visibles.
Face à des skills plus courtes comme Stop Slop, Humanizer est plus complet et plus prudent sur les faits. Pour auditer de nombreux documents de façon automatisée, un linter déterministe ou un outil de CI sera plus reproductible. Pour imiter une voix particulière, l’échantillon fourni par l’auteur est plus important que la seule liste de mots interdits.
Verdict
Très bonne seconde passe pour nettoyer un brouillon et apprendre à reconnaître les automatismes des modèles. Son bénéfice crédible est la lisibilité perçue, pas l’évasion des détecteurs. Les meilleurs résultats viennent d’un échantillon de voix, d’un contexte clair et d’une relecture qui vérifie le sens, le rythme et les détails factuels.
Sources
Sources des avis
- Test pratique de Humanizer par StashBase
- Étude à l’aveugle : qualité améliorée, détection inchangée
- Retour sur les réponses conversationnelles encore trop explicatives
- Discussion sur les différences entre langues
- Comparaison communautaire de huit outils open source
- Retour d’usage pour des contenus destinés à des clients
- Discussion critique sur l’exemple de la version 3.0.0
Dernière analyse : 12 novembre 2026