Skill officielle Anthropic qui outille tout le cycle de vie d’une Agent Skill : cadrage de l’intention, rédaction du
SKILL.md, génération de cas de test, exécution en parallèle de runs avec/sans skill via sous-agents, évaluation qualitative et quantitative dans un viewer HTML, itération guidée, puis optimisation de la description pour la fiabilité du déclenchement.
Composition : 1 skill, sous-agents (grader, comparator, analyzer).
Voir aussi : la section Avis indépendants pour une synthèse des retours et réserves, et Skill Creator mémo pour le mémo pratique.
Résumé
Skill Creator est la skill officielle d’Anthropic, distribuée dans le dépôt Claude-Plugins-Official, pour créer et améliorer itérativement d’autres Agent Skills. Plutôt que de se limiter à un gabarit de SKILL.md, elle formalise une boucle complète : interviewer l’utilisateur sur l’intention et les cas limites, rédiger un brouillon de skill, générer des prompts de test réalistes, lancer en parallèle (via sous-agents) une exécution « avec skill » et une exécution de référence (« sans skill » ou version précédente), noter les résultats avec des assertions objectives, présenter le tout dans un viewer HTML généré par script (eval-viewer/generate_review.py), puis réviser la skill à partir du retour utilisateur.
Elle couvre aussi un aspect souvent négligé du travail sur les skills : la fiabilité du déclenchement. Une section dédiée d’« optimisation de description » génère 20 requêtes de test (cas qui doivent déclencher la skill et cas limites qui ne doivent pas la déclencher), fait valider ce jeu de test par l’utilisateur via un template HTML, puis lance une boucle d’optimisation automatique (scripts/run_loop.py) qui teste et réécrit la description sur plusieurs itérations en séparant train/test pour éviter le sur-ajustement.
La skill adapte explicitement son comportement selon l’environnement d’exécution (Claude Code avec sous-agents et navigateur, Claude.ai sans sous-agents ni navigateur, Cowork avec sous-agents mais sans affichage), ce qui en fait aussi un exemple de référence sur la manière d’écrire une skill robuste à plusieurs contextes d’exécution.
Fonctionnalités
-
Cadrage de l’intention : extraction du besoin depuis la conversation existante (« transforme ceci en skill ») ou interview structurée (objectif, déclencheurs, format de sortie, besoin de cas de test).
-
Guide de rédaction du SKILL.md : anatomie standard d’une skill (frontmatter, corps,
scripts/,references/,assets/), principe de « divulgation progressive » en trois niveaux (métadonnées, corps du SKILL.md, ressources embarquées), limite indicative de 500 lignes. -
Génération de cas de test : 2-3 prompts réalistes proposés à l’utilisateur, enregistrés dans
evals/evals.jsonsans assertions dans un premier temps. -
Exécution parallèle avec/sans skill : pour chaque cas de test, deux sous-agents sont lancés dans le même tour (run avec la skill vs run de référence sans skill ou version antérieure), avec sauvegarde structurée des sorties par itération et par cas.
-
Notation et agrégation : rédaction d’assertions objectivement vérifiables pendant que les runs tournent, grading via un sous-agent dédié (
agents/grader.md), agrégation enbenchmark.json/benchmark.md(taux de réussite, temps, tokens) viascripts/aggregate_benchmark. -
Viewer HTML de revue : génération d’un rapport interactif (
generate_review.py) avec un onglet « Outputs » (comparaison par cas de test, feedback en ligne) et un onglet « Benchmark » (statistiques quantitatives), avec mode statique pour les environnements sans navigateur. -
Boucle d’itération : amélioration de la skill à partir du feedback utilisateur, nouvelle exécution des cas de test dans une itération suivante, jusqu’à satisfaction ou absence de progrès mesurable.
-
Comparaison à l’aveugle (avancé) : jugement indépendant de deux versions d’une skill par un agent qui ignore laquelle est laquelle (
agents/comparator.md,agents/analyzer.md). -
Optimisation de la description : génération de 20 requêtes de test de déclenchement (cas positifs/négatifs, y compris des « quasi-échecs » volontairement ambigus), validation par l’utilisateur, puis boucle d’optimisation automatique de la description avec séparation train/test.
-
Packaging : empaquetage final de la skill en fichier
.skillviascripts/package_skill.py, prêt à être installé. -
Adaptation multi-environnement : instructions spécifiques pour Claude Code (sous-agents + navigateur), Claude.ai (sans sous-agents ni navigateur, revue directement dans la conversation) et Cowork (sous-agents mais sans affichage, viewer en mode statique).
Analyse
| Critère | Note |
|---|---|
| Documentation | ★★★★☆ |
| Précision des descriptions | ★★★★☆ |
| Maturité | ★★★☆☆ |
| Popularité | — |
Notes Documentation, Précision et Maturité alignées sur le barème global (10 octobre 2026). Popularité non notée : l’outil est un sous-dossier du dépôt
anthropics/claude-plugins-official, dont les étoiles mesurent l’ensemble.
Points forts
-
Méthodologie complète et structurée : va bien au-delà d’un simple gabarit, en intégrant tests, évaluation quantitative/qualitative et itération dans un seul flux outillé.
-
Traitement explicite du problème de déclenchement, souvent le point faible des skills mal conçues, via une boucle d’optimisation de description séparée en train/test pour éviter le sur-ajustement.
-
Bonnes pratiques d’écriture de skills bien articulées : divulgation progressive, explication du « pourquoi » plutôt que des injonctions rigides (« MUST » en majuscules signalé comme un signal d’alerte), organisation par domaine pour les skills multi-variantes.
-
Robustesse multi-environnement documentée noir sur blanc (Claude Code, Claude.ai, Cowork), utile comme référence pour quiconque écrit ses propres skills destinées à plusieurs contextes.
-
Distribution officielle et maintenue par Anthropic, dans un dépôt avec un rythme de contributions soutenu.
Limites
-
Workflow assez lourd pour de petites skills ou des itérations rapides : la boucle complète (interview, cas de test, sous-agents, viewer, grading) suppose un contexte avec sous-agents et souvent un navigateur, ce qui la rend moins adaptée aux ajustements mineurs.
-
Dépendante de l’environnement d’exécution : plusieurs fonctionnalités (sous-agents, navigateur,
claude -ppour l’optimisation de description) ne sont disponibles que dans certains contextes (Claude Code), avec des replis plus pauvres ailleurs (Claude.ai, Cowork). -
Risque de circularité et de sur-optimisation : des cas de test générés par le même modèle peuvent refléter les hypothèses de la skill, et un score parfait sur quelques cas ne garantit pas la généralisation ; il faut compléter avec de vrais cas, un jeu de validation séparé et une revue humaine du domaine. Le coût en tokens est significatif, et le dispositif complet est disproportionné pour une instruction très simple.
-
Peu pertinente hors de l’écosystème Claude : le format
SKILL.mdet les mécanismes de déclenchement décrits sont spécifiques aux Agent Skills d’Anthropic, non réutilisables tels quels avec d’autres frameworks d’agents. -
Documentation en tant que fichier unique volumineux : le
SKILL.mdest dense et long, ce qui va à l’encontre de la limite de 500 lignes qu’il recommande lui-même pour les skills qu’il aide à créer.
Qualité
Commentaire : skill exemplaire sur le fond (méthodologie d’évaluation rigoureuse, bonnes pratiques d’écriture bien justifiées) et maintenue directement par Anthropic dans le dépôt officiel des plugins. La note de maturité est légèrement en retrait uniquement parce que la robustesse de certaines étapes (sous-agents, navigateur) dépend fortement de l’environnement d’exécution.
Relations
-
Alternative à : écriture manuelle d’une skill (plus rapide, moins reproductible) et linters de structure (qui vérifient la forme, pas l’efficacité comportementale)
-
S’intègre avec : Claude Code, Claude.ai, Cowork
-
Utilise : Agent Skills (format
SKILL.md), sous-agents,claude -p(pour l’optimisation de description)
Mémo pratique
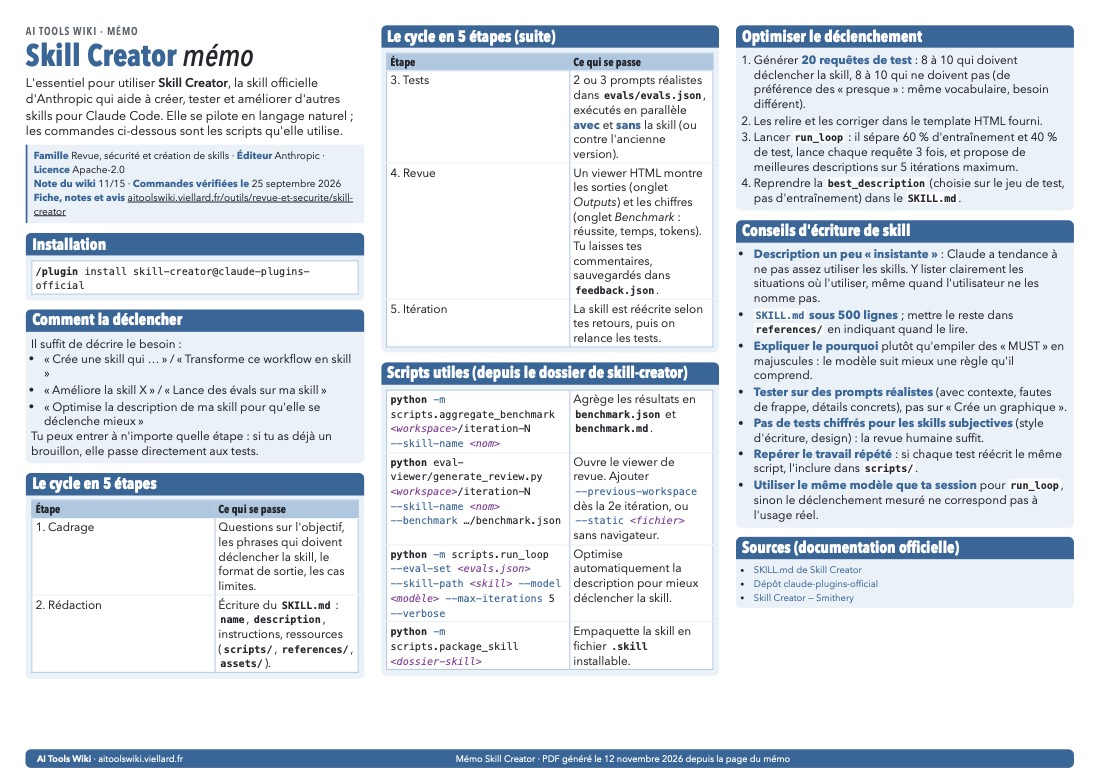
Télécharger le mémo en PDF (1 page A4 paysage, 189 Ko). Il est généré depuis la page du mémo, qui reste la version de référence : commandes à copier, recherche dans le site.
Avis indépendants
Synthèse des retours publiés, mise à jour le 24 septembre 2026.
Synthèse
Les retours sont très favorables à la version fondée sur les évaluations : elle ne se contente plus de générer un SKILL.md, mais aide à définir des cas de test, comparer avec/sans skill, examiner les sorties et améliorer le déclenchement. Des utilisateurs rapportent des gains mesurables et apprécient le visualiseur d’évals.
La prudence tient au coût et au risque de sur-optimisation. Les tests générés par le même modèle peuvent refléter les hypothèses de la skill, et un score parfait sur quelques cas ne garantit pas la généralisation. La qualité finale dépend toujours de l’expertise du propriétaire du processus. Pour une instruction très simple, le dispositif complet est disproportionné.
Comparaison
Écrire manuellement une skill est plus rapide mais moins reproductible. Les linters vérifient la structure, pas l’efficacité comportementale. Skill Creator se distingue par sa boucle construire–évaluer–réviser et son optimisation du texte de déclenchement.
Verdict
La meilleure base pour créer une skill importante et maintenue ; compléter ses évals avec de vrais cas, un jeu de validation séparé et une revue humaine du domaine.
Sources
Sources des avis
- Bonnes pratiques officielles
- Retour avec amélioration du taux de réussite
- Approche d’ingénierie des Agent Skills
Dernière analyse : 12 novembre 2026