Ensemble d’outils de revue de code d’Anthropic : une commande
/code-reviewintégrée à Claude Code (revue locale réglable en profondeur), une revue approfondie dans le cloud (« ultrareview ») où une flotte d’agents vérifie chaque problème, et un service managé qui relit automatiquement les pull requests GitHub pour les équipes.
Composition : 1 skill, flotte multi-agents.
Licence : le dépôt anthropics/claude-code est « © Anthropic PBC. All rights reserved » et son usage est soumis aux conditions commerciales d’Anthropic ; il contient aussi l’ancien plugin code-review.
Voir aussi : la section Avis indépendants pour une synthèse des retours et réserves, et Claude Code Review mémo pour le mémo pratique.
Résumé
La revue de code d’Anthropic existe aujourd’hui sous trois formes, de la plus légère à la plus poussée.
1. /code-review en local. Ce qui était un plugin est désormais une commande intégrée à Claude Code (/review en est un alias depuis la v2.1.223). Elle relit les commits non poussés de la branche et les changements en cours, ou une cible précise : fichier, numéro de PR, branche, plage de commits. Elle tourne en arrière-plan dans un sous-agent, pour ne pas encombrer la conversation. Un niveau d’effort règle le compromis : low et medium ne remontent que les problèmes les plus sûrs, high à max élargissent la couverture au prix de quelques faux positifs. Les options --fix (appliquer les corrections) et --comment (publier sur une PR GitHub ou une MR GitLab) complètent le tout.
2. Ultrareview (/code-review ultra). Une flotte d’agents de revue tourne dans un bac à sable cloud, et chaque problème signalé est reproduit et vérifié indépendamment. Compter 5 à 10 minutes. Après 3 revues offertes sur les forfaits Pro et Max, chaque revue coûte environ 5 à 25 $ en crédits d’usage. La commande claude ultrareview permet de la lancer depuis une CI.
3. Le service Code Review (Team et Enterprise, en research preview). Une fois la GitHub App installée par un administrateur, les PR sont relues automatiquement, à l’ouverture, à chaque push ou à la demande (@claude review). Les problèmes arrivent en commentaires sur les lignes concernées, classés 🔴 Important, 🟡 Nit ou 🟣 Pré-existant. Le check GitHub se termine toujours en neutre : il ne bloque jamais un merge. Anthropic annonce un coût moyen de 15 à 25 $ par revue et environ 20 minutes d’analyse.
L’ancien plugin code-review, toujours présent dans le dépôt (dernière modification en mars 2026), lance 4 agents en parallèle (deux pour le respect de CLAUDE.md, un pour les bugs, un pour l’historique git) et ne garde que les problèmes notés au moins 80/100 en confiance. La commande intégrée prend désormais le relais.
Fonctionnalités
-
Revue locale
/code-review: cible au choix (changements en cours, PR, branche, fichier, plagemain...ma-branche), exécution en arrière-plan, niveau d’effort delowàmax, dernier niveau tapé réutilisé automatiquement. -
Corrections et publication :
--fixapplique les corrections dans le working tree ;--commentpublie en commentaires inline sur GitHub ou en note sur GitLab (viaglab). -
Déclenchement par Claude : Claude peut lancer la revue quand on lui demande de relire du code, ou via une tâche planifiée. Désactivable avec
skillOverrides("code-review": "user-invocable-only"). -
Ultrareview : flotte d’agents dans le cloud, vérification indépendante de chaque problème, comparaison à une autre branche de base, consigne en texte libre (
/code-review ultra vérifie mes changements d'auth), publication optionnelle sur la PR (--post), suivi via/tasks. -
Ultrareview en CI :
claude ultrareview [PR | base], avec--json,--timeoutet--post, et des codes de sortie exploitables. -
Service managé GitHub : déclenchement « une fois à la création », « à chaque push » ou manuel ; commandes
@claude review,@claude review always(abonne la PR aux pushes suivants),@claude review once. -
Résultats structurés : niveaux de gravité, raisonnement détaillé dépliable, annotations dans l’onglet Files changed, tableau récapitulatif dans le check run, compteur lisible par machine pour bloquer un merge dans sa propre CI.
-
Personnalisation :
CLAUDE.md(écarts signalés en Nit) etREVIEW.md(règles propres à la revue : définition de « Important », plafond de nits, chemins ignorés, vérifications systématiques). -
Suivi des coûts : tableau de bord d’analytics et plafond de dépense mensuel pour le service managé.
-
PR Review Toolkit : agents de revue spécialisés (tests, commentaires, gestion des erreurs, types, simplification) pour une revue plus modulaire.
Analyse
| Critère | Note |
|---|---|
| Documentation | ★★★★★ |
| Précision des descriptions | ★★★☆☆ |
| Qualité de détection | ★★★☆☆ |
| Réduction des faux positifs | ★★★☆☆ |
| Personnalisation | ★★★★★ |
| Intégration GitHub | ★★★★★ |
| Maturité | ★★★☆☆ |
| Popularité | — |
| Rapport coût / bénéfice | ★★★☆☆ |
Notes Documentation, Précision et Maturité alignées sur le barème global (10 octobre 2026). Popularité non notée : l’outil fait partie du dépôt
anthropics/claude-code, dont les étoiles mesurent Claude Code.
Commentaire : l’offre est désormais échelonnée, ce qui règle en partie le problème de coût : une revue locale presque gratuite pendant le développement, une ultrareview payante à la demande avant un merge important, et le service automatique pour les équipes. La vérification indépendante de chaque problème (ultrareview et service managé) est le principal argument contre les revues IA bruyantes. Anthropic annonce moins de 1 % de problèmes jugés incorrects et 84 % des grosses PR (plus de 1 000 lignes) avec au moins un problème trouvé ; ce sont des chiffres internes, non une évaluation indépendante, ce qui explique des notes de détection, de faux positifs et de rapport coût/bénéfice de ★★★☆☆. Aucun agent de revue ne domine tous les types de défauts dans les benchmarks externes (voir les avis indépendants).
Points forts
-
Profondeur réglable : du contrôle rapide en local (
low) à la flotte vérifiée dans le cloud (ultra), selon l’enjeu du changement. -
Vérification indépendante des problèmes dans ultrareview et le service managé, ce qui limite les faux positifs.
-
Revue en arrière-plan : la revue locale ne consomme pas le contexte de la conversation.
-
Ne bloque jamais le workflow : le check GitHub reste neutre ; chaque équipe décide si elle veut bloquer un merge à partir des données fournies.
-
Personnalisation fine avec
REVIEW.md: gravité, volume de nits, fichiers ignorés, règles spécifiques au dépôt. -
GitHub et GitLab pour la publication locale (
--comment), et intégration CI parclaude ultrareview.
Limites
-
Coût du service managé : 15 à 25 $ par revue en moyenne, multiplié si la revue tourne à chaque push. Facturé à part du forfait.
-
Coût d’ultrareview : 5 à 25 $ par revue après les 3 revues offertes (Pro et Max uniquement, une seule fois par compte).
-
Disponibilité limitée : ultrareview et le service managé ne sont pas disponibles sur Bedrock, Vertex ou Foundry, ni pour les organisations en Zero Data Retention ; le service managé est réservé aux forfaits Team et Enterprise.
-
REVIEW.mdignoré en local : seul le service managé le lit ;/code-reviewsuit uniquementCLAUDE.md. -
--fixen arrière-plan non annulable par/rewind: il faut revenir en arrière avec git. -
Limites de taille pour ultrareview : environ 500 fichiers et 8 000 lignes modifiés par défaut.
-
Pas un remplacement de la revue humaine : les problèmes d’architecture, métier ou de contexte restent difficiles à déduire du code.
-
Fausse confiance et angles morts partagés : commentaires plausibles mais non actionnables, faux positifs, et angles morts communs quand l’auteur et le reviewer utilisent des modèles proches — le cas typique est du code écrit par Claude relu par Claude. Une revue croisée avec un modèle différent (par exemple Codex) peut améliorer le résultat, l’ordre des revues comptant ; tests, analyse statique et revue humaine restent indispensables.
-
Plus verbeux que certains concurrents : CodeRabbit est plus spécialisé dans la revue continue de PR et Codex produit une revue plus concise ; Claude se distingue par l’explication architecturale et la lecture du contexte.
-
Produit en évolution rapide : ultrareview et le service managé sont en research preview ; le comportement de
@claude reviewa changé en juillet 2026 (il n’abonne plus la PR aux pushes suivants).
Relations
-
Alternative à : CodeRabbit · GitHub Copilot Code Review · Cursor Bugbot
-
S’intègre avec : GitHub · GitHub Actions · GitLab · Claude Code
-
Utilise : Claude Code · Git · GitHub CLI (
gh) · GitLab CLI (glab) ·CLAUDE.md·REVIEW.md
Positionnement
Claude Code Review est particulièrement utile quand le code est produit vite par des agents et que la capacité de revue humaine devient le goulet d’étranglement.
En pratique : /code-review pendant qu’on travaille, /code-review ultra avant de merger un changement important ou risqué, et le service managé pour les équipes qui veulent une revue automatique sur chaque PR.
Mémo pratique
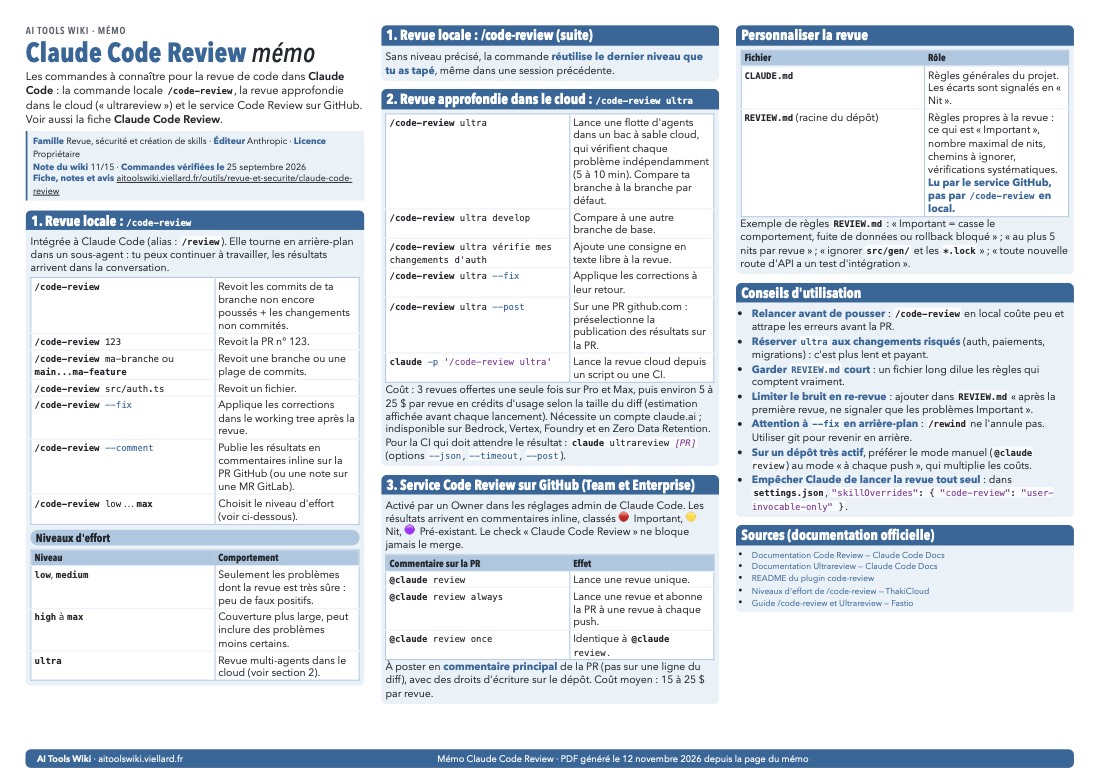
Télécharger le mémo en PDF (1 page A4 paysage, 219 Ko). Il est généré depuis la page du mémo, qui reste la version de référence : commandes à copier, recherche dans le site.
Avis indépendants
Synthèse des retours publiés, mise à jour le 24 septembre 2026.
Synthèse
Claude Code Review est apprécié pour sa compréhension du contexte du dépôt, sa capacité à expliquer les problèmes et son intégration au flux de développement. Les comparaisons montrent toutefois qu’aucun agent de revue ne domine tous les types de défauts. Les travaux récents estiment encore qu’un ensemble de reviewers automatisés ne résout qu’une partie des cas difficiles.
Le risque principal est la fausse confiance : commentaires plausibles mais non actionnables, faux positifs et angles morts communs entre auteur et reviewer utilisant des modèles proches. Une étude contrôlée sur la revue croisée indique qu’un modèle différent peut améliorer le résultat, mais l’ordre compte. La revue humaine, les tests et l’analyse statique restent indispensables.
Comparaison
CodeRabbit est plus spécialisé dans la revue continue de pull requests, avec configuration par chemins, analyse de graphe et commentaires GitHub. Codex fournit une revue intégrée et concise. Claude se distingue davantage par l’explication architecturale et la lecture du contexte, mais peut être plus verbeux.
Verdict
Très bon premier filet et partenaire de revue ; pas une approbation automatique. Pour les changements critiques, combiner modèle différent, tests, SAST et humain.
Sources
Sources des avis
- Comparatif Claude Code et CodeRabbit
- Benchmark d’agents de code review
- Étude de revue croisée Claude/Codex
Dernière analyse : 12 novembre 2026