API open source d’accès au web conçue pour les agents IA : recherche, scraping, crawling, interaction avec les pages et extraction de données propres en Markdown ou JSON. Firecrawl fournit également un serveur MCP, une CLI et un catalogue de Skills pour les agents.
Composition : 27+ skills, 1 agent, 13+ outils MCP.
Voir aussi : la section Avis indépendants pour une synthèse des retours et réserves, et Firecrawl mémo pour le mémo pratique.
Résumé
Firecrawl est une infrastructure Web Data for AI Agents qui transforme le web réel en données directement exploitables par les LLM et agents. Le projet combine recherche web, scraping, parsing de documents, découverte d’URLs, crawling, interaction avec des pages dynamiques et recherche autonome.
Son intérêt principal est d’abstraire la complexité du web moderne — JavaScript, pages dynamiques, navigation, contenu parasite, crawling et extraction — afin de fournir aux agents du contenu propre et structuré.
Le projet est open source sous AGPL-3.0, avec une version Cloud proposant des fonctionnalités et une infrastructure hébergées supplémentaires. Les SDK et certains composants sont sous MIT.
Fonctionnalités
-
Search — recherche le web et retourne directement le contenu des pages trouvées.
-
Scrape — transforme une URL en Markdown, HTML, JSON structuré ou screenshot.
-
Crawl / Map — découvre et explore les pages d’un site entier.
-
Interact — permet à un agent de cliquer, saisir, faire défiler et naviguer sur une page avant extraction.
-
Agent — recherche et collecte automatiquement des informations à partir d’une demande en langage naturel.
-
Parse — transforme des PDF, DOCX et autres documents en contenu exploitable.
-
Batch Scrape — traite de grands volumes d’URLs de manière asynchrone.
-
MCP / CLI / Skills — intégration directe avec Claude Code, Cursor, Codex, OpenCode et autres environnements agentiques.
Analyse
| Critère | Note |
|---|---|
| Documentation | ★★★★☆ |
| Précision des descriptions | ★★★★☆ |
| Richesse fonctionnelle | ★★★★★ |
| Intégration agents / MCP | ★★★★★ |
| Maturité | ★★★★☆ |
| Popularité | ★★★★★ |
| Qualité de l’architecture | ★★★★☆ |
| Self-hosting | ★★★☆☆ |
| Simplicité d’utilisation | ★★★★☆ |
Notes Documentation, Précision et Maturité alignées sur le barème global (10 octobre 2026). Popularité calculée depuis les étoiles du dépôt GitHub : 202 189 au 16 novembre 2026.
Commentaire : projet établi et très actif (plus de 6 000 commits et plusieurs centaines de contributeurs ; sa popularité mesure surtout l’attention). L’écosystème s’est étendu au-delà du scraping traditionnel vers Search, Interact, Agent, MCP, CLI et Skills. Les sources de cette fiche sont toutes celles de l’éditeur ; les retours indépendants (voir les avis indépendants) le décrivent comme un excellent choix par défaut pour intégrer rapidement le web à un agent, avec des réserves sur le coût à volume élevé, les sites difficiles et l’écart entre auto-hébergement et cloud, d’où la note de maturité et de self-hosting plus prudente.
La documentation est particulièrement développée pour les workflows agentiques : Firecrawl fournit désormais des Skills dédiés à la recherche, au scraping, au crawling, au SEO, au competitive intelligence, au market research, au lead research, au QA et à la constitution de knowledge bases.
Points forts
-
Couverture fonctionnelle très large : Search → Scrape → Crawl → Interact → Agent dans une même plateforme.
-
Très bonne intégration avec les agents IA grâce au MCP, à la CLI et aux Skills pour plusieurs coding agents.
-
Sorties adaptées aux LLM : Markdown propre, JSON structuré, screenshots et contenu de documents.
-
Abstraction de la complexité du web : rendu JavaScript, proxies, rate limiting, orchestration et navigation.
-
Self-hosting disponible, permettant de conserver une maîtrise de l’infrastructure lorsque nécessaire, sans reproduire nécessairement toute la simplicité opérationnelle du cloud.
-
Écosystème très actif : le dépôt principal est continuellement enrichi et plusieurs repositories complémentaires couvrent MCP, documentation, CLI, Skills et composants spécialisés.
-
Agent web open source : la stack
firecrawl-agentpermet de construire un agent personnalisé en combinant Search, Scrape et Interact avec différents modèles.
Limites
-
AGPL-3.0 sur le cœur du projet : à prendre en compte pour une intégration ou une redistribution dans un produit propriétaire.
-
Complexité croissante : l’écosystème couvre désormais API, MCP, CLI, Skills, Workflows et Agents ; cette richesse peut rendre le choix du bon composant moins évident.
-
Dépendance possible au Cloud pour bénéficier simplement de l’infrastructure de scraping à grande échelle, même si le cœur du projet est self-hostable.
-
Coût potentiel à grande échelle lorsque Search, Crawl, Interact et Agent sont combinés sur de nombreux workflows.
-
Le scraping ne garantit pas la fiabilité des informations : Firecrawl collecte et structure les données mais ne remplace pas la validation, le recoupement des sources ou le raisonnement de l’agent.
-
Chevauchement avec d’autres outils de recherche web : selon le besoin, Search/Research peut recouvrir des fonctionnalités proposées par des services comme Exa ou Perplexity.
-
Aucun scraper ne supprime les obstacles du web : robots.txt, CAPTCHA, protections anti-bot, changements de structure des sites et conformité (CGU, données personnelles) restent à gérer, et certains sites difficiles échappent à l’extraction.
Relations
-
Alternative à : Crawl4AI (open source local et très configurable), Apify (marketplace d’acteurs et infrastructure de scraping plus large) et solutions sur mesure développées avec Playwright + parsers
-
Complémentaire de : Perplexity MCP (réponses sourcées ; Firecrawl extrait ensuite les pages citées)
-
S’intègre avec : Claude Code · Cursor · Codex · OpenCode · Windsurf · n8n · LangChain · LangGraph · LlamaIndex · Vercel AI SDK
-
Utilise : MCP · REST API · SDK Python/TypeScript · CLI · Skills
-
Écosystème associé : firecrawl-mcp-server, firecrawl-agent, firecrawl-skills, firecrawl-workflows
Mémo pratique
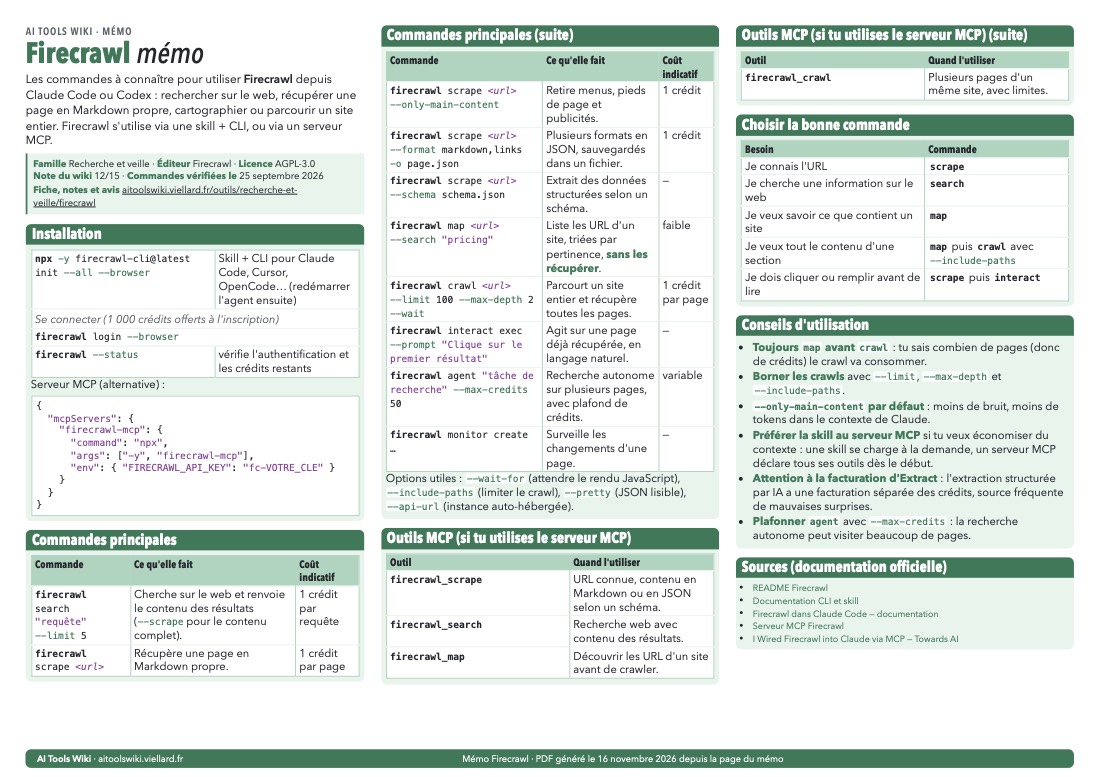
Télécharger le mémo en PDF (1 page A4 paysage, 202 Ko). Il est généré depuis la page du mémo, qui reste la version de référence : commandes à copier, recherche dans le site.
Avis indépendants
Synthèse des retours publiés, mise à jour le 24 septembre 2026.
Synthèse
Firecrawl est régulièrement cité comme l’option la plus simple pour transformer des sites en Markdown ou données prêtes pour un LLM. L’API unifiée, le rendu JavaScript, le crawl de site et les formats structurés réduisent fortement le temps d’intégration. C’est son principal avantage sur une pile maison.
Les critiques portent sur les coûts à volume élevé, les quotas, les sites difficiles et la dépendance à un service tiers. Aucun scraper ne supprime les problèmes de robots, CAPTCHA, changements de structure ou conformité. L’auto-hébergement existe, mais ne reproduit pas nécessairement toute la simplicité opérationnelle du cloud.
Comparaison
Crawl4AI attire les équipes qui veulent une solution open source locale et très configurable. Apify propose un marketplace d’acteurs et une infrastructure plus large pour le scraping. Playwright offre le contrôle le plus bas niveau mais exige de construire extraction, files et reprise. Firecrawl gagne quand la vitesse d’intégration et une sortie optimisée LLM priment.
Verdict
Excellent choix par défaut pour ajouter rapidement le web à un agent ; à comparer avec Crawl4AI ou Apify dès que volume, coût ou cas spécialisés deviennent centraux.
Sources
Sources des avis
Dernière analyse : 15 novembre 2026