Plugin de mémoire persistante pour les agents de développement. Claude-Mem capture les activités des sessions, les compresse en observations sémantiques et réinjecte les informations pertinentes dans les sessions suivantes afin de conserver le contexte au-delà d’une conversation.
Composition : plusieurs outils MCP de recherche dans la mémoire.
Voir aussi : la section Avis indépendants pour une synthèse des retours et réserves, et Claude-Mem mémo pour le mémo pratique.
Résumé
Claude-Mem est un système de mémoire persistante et de compression de contexte initialement conçu pour Claude Code. Il utilise les hooks du client pour observer les activités de l’agent, transforme les événements en observations synthétiques avec un modèle LLM, les stocke localement puis récupère automatiquement les éléments pertinents lors des sessions ultérieures.
L’installation est effectuée au niveau de l’environnement utilisateur et non directement dans chaque dépôt : le plugin est installé dans ~/.claude/plugins/ et les données dans ~/.claude-mem/, notamment une base SQLite. Le répertoire de données peut être personnalisé.
Le projet a fortement évolué et supporte désormais plusieurs environnements d’agents, mais son positionnement historique reste celui d’une mémoire persistante pour les coding agents.
Fonctionnalités
-
Mémoire persistante inter-session : conservation des observations, corrections et décisions entre plusieurs sessions.
-
Capture automatique : observation des activités de l’agent via les hooks.
-
Compression sémantique : transformation des événements de session en informations synthétiques.
-
Recherche progressive : récupération de contexte pertinent plutôt que réinjection systématique de l’historique complet.
-
Stockage local : SQLite pour les données persistantes, avec Chroma pour certaines fonctions de recherche vectorielle.
-
Injection automatique de contexte : les souvenirs pertinents peuvent être ajoutés aux nouvelles sessions.
-
Web Viewer : interface locale permettant d’inspecter la mémoire enregistrée.
-
MCP / recherche mémoire : accès programmatique à l’historique et aux observations.
-
Context Files : génération de fichiers de contexte dans les dossiers de projet.
-
Contrôle de la configuration : modèle utilisé, répertoire de données, worker, injection de contexte, etc.
-
Support multilingue : documentation et modes de fonctionnement couvrant notamment le français, l’anglais, le chinois et le japonais.
Analyse
| Critère | Note |
|---|---|
| Documentation | ★★★★☆ |
| Précision des descriptions | ★★★☆☆ |
| Fonctionnalité | ★★★★★ |
| Intégration Claude Code | ★★★★★ |
| Recherche / récupération mémoire | ★★★★☆ |
| Contrôle de la mémoire | ★★★☆☆ |
| Transparence des coûts | ★★★☆☆ |
| Maturité | ★★★☆☆ |
| Popularité | ★★★★★ |
| Stabilité | ★★★☆☆ |
| Pertinence multi-agent | ★★★★☆ |
Notes Documentation, Précision et Maturité alignées sur le barème global (10 octobre 2026). Popularité calculée depuis les étoiles du dépôt GitHub : 117 508 au 16 novembre 2026.
Commentaire : Claude-Mem répond à un problème réel des coding agents : la perte de contexte entre les sessions. Son architecture est désormais relativement riche et son adoption rapide, mais le projet évolue très rapidement et les retours vérifiables restent moins nombreux que sa popularité ne le suggère (voir les avis indépendants). Le volume important de correctifs récents concerne notamment le worker, les hooks, la synchronisation, les quotas, Chroma et la récupération de contexte.
Points forts
-
Continuité inter-session : permet à l’agent de conserver une connaissance historique du travail effectué.
-
Automatisation : pas besoin de documenter manuellement chaque découverte ou décision.
-
Intégration native avec les hooks de l’environnement d’agent.
-
Recherche progressive permettant de limiter la quantité de contexte réinjectée.
-
Stockage local par défaut, avec données conservées dans
~/.claude-mem/. -
Observabilité grâce au Web Viewer et aux données structurées.
-
Écosystème actif : nombreuses releases, contributions et corrections.
-
Open source sous licence Apache-2.0.
Limites
-
Coût en tokens : la génération et la compression des observations nécessitent elles-mêmes du calcul LLM ; des utilisateurs ont signalé une consommation importante selon leur configuration.
-
Risque de faux souvenirs : une observation générée automatiquement peut transformer une hypothèse ou une erreur en information mémorisée.
-
Contexte obsolète : une décision ancienne peut ne plus correspondre à l’état actuel du code.
-
Risque de bruit : une mémoire volumineuse peut conduire à injecter des informations peu pertinentes.
-
Complexité supplémentaire : worker local, hooks, SQLite, Bun, uv et éventuellement Chroma ajoutent plusieurs composants à maintenir.
-
Stabilité encore perfectible : les issues et pull requests de septembre 2026 montrent encore de nombreux correctifs concernant le worker, les hooks, les quotas et la récupération mémoire.
-
Mémoire automatique ≠ source de vérité : les décisions structurantes doivent rester dans la documentation, les ADR, les issues ou le code versionné.
-
Gouvernance multi-agent : plusieurs agents travaillant sur un même projet peuvent alimenter et consommer une mémoire commune, ce qui nécessite une stratégie de séparation et de contrôle.
-
La mémoire native réduit le besoin pour les cas simples : la mémoire automatique de Claude Code (
MEMORY.md) couvre une partie des usages ; pour un seul dépôt, commencer par elle et par des fichiers Markdown relus à la main est plus transparent. Certains utilisateurs ont d’ailleurs remplacé Claude-Mem par quelques fichiers explicites. -
Recul vérifiable limité : la croissance très rapide de l’audience du dépôt dépasse le volume de retours indépendants détaillés ; l’un des témoignages les plus cités porte sur une consommation de tokens très élevée.
Relations
-
Alternative à : Engram, Mem0, Supermemory, MemPalace, la mémoire automatique native de Claude Code et des fichiers de statut explicites (
CLAUDE.md,MEMORY.md) -
S’intègre avec : Claude Code
-
S’intègre avec : MCP
-
Utilise : Claude Agent SDK
-
Utilise : SQLite
-
Utilise : Chroma
Positionnement
Claude-Mem doit être considéré comme une mémoire épisodique automatique, et non comme une base de connaissances faisant autorité.
Une architecture robuste distingue généralement :
| Type d’information | Support recommandé |
|---|---|
| Règles permanentes | CLAUDE.md |
| Architecture | Documentation du projet |
| Décisions structurantes | ADR |
| Travail à effectuer | Issues / tâches |
| État réel du système | Code + tests + Git |
| Historique des sessions | Claude-Mem |
| Connaissances automatiquement découvertes | Claude-Mem |
Cette séparation limite le risque qu’une observation générée automatiquement soit considérée comme une décision officielle.
Mémo pratique
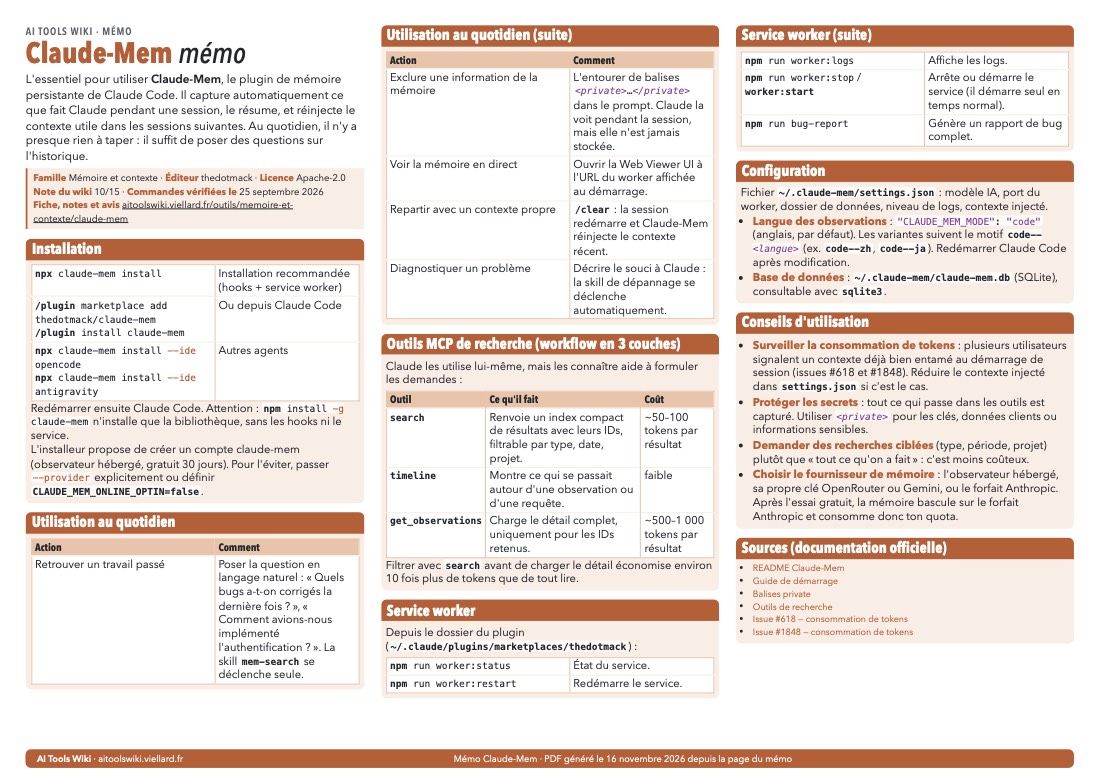
Télécharger le mémo en PDF (1 page A4 paysage, 189 Ko). Il est généré depuis la page du mémo, qui reste la version de référence : commandes à copier, recherche dans le site.
Avis indépendants
Synthèse des retours publiés, mise à jour le 24 septembre 2026.
Synthèse
Les utilisateurs qui aiment Claude-Mem apprécient la capture automatique des sessions, la recherche transversale et le fait de retrouver du contexte sans entretenir manuellement un journal. Pour des projets longs ou plusieurs agents, cette continuité peut éviter de réexpliquer les mêmes décisions.
Les critiques sont toutefois substantielles : consommation de tokens, bruit de récupération, informations devenues fausses, complexité du daemon et de la base vectorielle. Certains utilisateurs ont remplacé le système par quelques fichiers Markdown explicites et plus faciles à auditer. L’arrivée de la mémoire native de Claude Code réduit aussi le besoin pour les cas simples. Enfin, la croissance très rapide du dépôt et le faible volume de retours vérifiables suscitent une prudence légitime.
Comparaison
Mem0 extrait des faits réutilisables et vise plusieurs frameworks ; MemPalace propose une organisation locale plus ambitieuse ; CLAUDE.md, MEMORY.md et des fichiers de statut restent plus transparents. Claude-Mem se distingue par l’automatisation via hooks et la recherche dans l’historique complet.
Verdict
Utile si le coût de l’oubli dépasse celui de l’infrastructure ; pour un seul dépôt, commencer par la mémoire native et des fichiers revus manuellement.
Sources
Sources des avis
- Comparaison de systèmes de mémoire
- Retour critique sur le coût en tokens
- Discussion sur mémoire explicite et implicite
Dernière analyse : 12 novembre 2026