Skill Claude Code qui transforme une question complexe en un processus de délibération multi-agents : cinq conseillers analysent indépendamment le problème, se relisent anonymement, puis un chairman synthétise les résultats en recommandation finale.
Voir aussi : la section Avis indépendants pour une synthèse des retours et réserves, et LLM Council mémo pour le mémo pratique.
Résumé
LLM Council est une skill pour Claude Code et Claude Cowork, créée par Ole Lehmann et inspirée de la méthodologie LLM Council d’Andrej Karpathy. Elle vise les décisions comportant une réelle incertitude ou un coût potentiel élevé en simulant un conseil de cinq perspectives cognitives différentes.
Le workflow repose sur trois niveaux : analyse indépendante → peer review anonyme → synthèse par un chairman. Contrairement au LLM Council original, qui peut comparer plusieurs modèles, cette implémentation utilise des sous-agents Claude avec des styles de raisonnement différents.
Le projet est volontairement minimal : le repository contient principalement README.md et SKILL.md, sans dépendance logicielle ou infrastructure particulière.
Fonctionnalités
-
5 conseillers indépendants : Contrarian, First Principles Thinker, Expansionist, Outsider et Executor.
-
Peer review anonyme : chaque conseiller évalue les cinq réponses sans connaître leur auteur.
-
Context enrichment : analyse préalable de
CLAUDE.md,memory/, fichiers pertinents et décisions précédentes avant de formuler la question. -
Chairman synthesis : synthèse des convergences, désaccords, angles morts et recommandation finale.
-
Déclenchement conversationnel :
council this,run the council,pressure-test this,stress-test this,war room this. -
Utilisation ciblée : conçu pour les décisions et arbitrages, pas pour les recherches factuelles ou tâches de génération simples.
Analyse
| Critère | Note |
|---|---|
| Documentation | ★★★☆☆ |
| Précision des descriptions | ★★★★☆ |
| Clarté du workflow | ★★★★★ |
| Qualité du prompting | ★★★★☆ |
| Diversité des perspectives | ★★★☆☆ |
| Robustesse méthodologique | ★★★☆☆ |
| Maturité | ★☆☆☆☆ |
| Popularité | ★★★☆☆ |
| Simplicité d’intégration | ★★★★★ |
| Utilité pour la prise de décision | ★★★☆☆ |
Notes Documentation, Précision et Maturité alignées sur le barème global (10 octobre 2026). Popularité calculée depuis les étoiles du dépôt GitHub : 3 089 au 16 novembre 2026.
Commentaire : bonne démonstration d’un workflow multi-agents obtenu avec une simple SKILL.md. Le processus est bien structuré : les cinq perspectives sont conçues pour créer des tensions complémentaires, le peer review est anonymisé et le chairman peut retenir l’avis minoritaire lorsqu’il estime son raisonnement supérieur. La clarté du workflow est excellente, mais l’utilité réelle pour la qualité des décisions n’est mesurée par aucune évaluation : les notes d’utilité, de robustesse et de diversité sont donc prudentes (voir les avis indépendants).
La principale limite est que les cinq conseillers restent des sous-agents du même environnement Claude : ils apportent une diversité de cadres de raisonnement, mais pas nécessairement une indépendance comparable à celle d’un véritable conseil composé de modèles différents. Le projet est également très léger techniquement, avec seulement trois commits et aucune release publiée.
Points forts
-
Workflow de délibération particulièrement simple à comprendre et à reproduire.
-
Bonne séparation entre génération, critique et synthèse.
-
Les cinq profils créent des tensions utiles : risque vs opportunité, principes fondamentaux vs exécution, expertise vs regard extérieur.
-
Le peer review anonyme limite le biais lié à l’identité du conseiller, sans supprimer les angles morts communs à des sous-agents d’un même modèle.
-
Le context enrichment permet de produire des réponses davantage ancrées dans le workspace.
-
Très faible complexité technique : le mécanisme est essentiellement contenu dans une skill Markdown.
-
Adapté aux arbitrages produit, stratégie, architecture, positionnement et autres décisions à plusieurs dimensions.
Limites
-
Les cinq conseillers utilisent des sous-agents Claude plutôt que plusieurs modèles réellement indépendants.
-
Le nombre d’agents et de tours augmente fortement le coût en tokens pour une décision simple.
-
Le système produit une recommandation, mais celle-ci reste une synthèse de raisonnement LLM et doit être vérifiée lorsque des faits externes sont déterminants.
-
Peu d’infrastructure ou de tests automatisés : le repository est essentiellement constitué du
SKILL.md. -
Projet encore relativement jeune : trois commits et aucune release publiée.
-
Il s’agit davantage d’un pattern d’orchestration/prompting que d’un framework multi-agents complet.
-
Licence non spécifiée : sans fichier de licence, les droits de réutilisation et de redistribution ne sont pas clairs.
-
Risque de consensus de modèles : ajouter des voix n’apporte rien si les prompts, outils et sources sont identiques ; le choix du juge et l’ordre des revues influencent fortement le résultat (une étude Claude/Codex observe même une asymétrie selon le modèle qui révise l’autre).
-
Aucune évaluation de la qualité des décisions : un simple second avis manuel d’un autre modèle est moins coûteux et peut apporter une diversité plus réelle.
Relations
-
Alternative à : une revue classique par un seul agent Claude ; un second avis manuel d’un autre modèle ; les plugins de council automatisés avec hooks et les implémentations réellement multi-modèles du concept de Karpathy
-
S’intègre avec : Claude Code, Claude Cowork, Agent Skills
-
Inspiré de : Andrej Karpathy - LLM Council
-
Utilise : Claude sub-agents,
SKILL.md
Mémo pratique
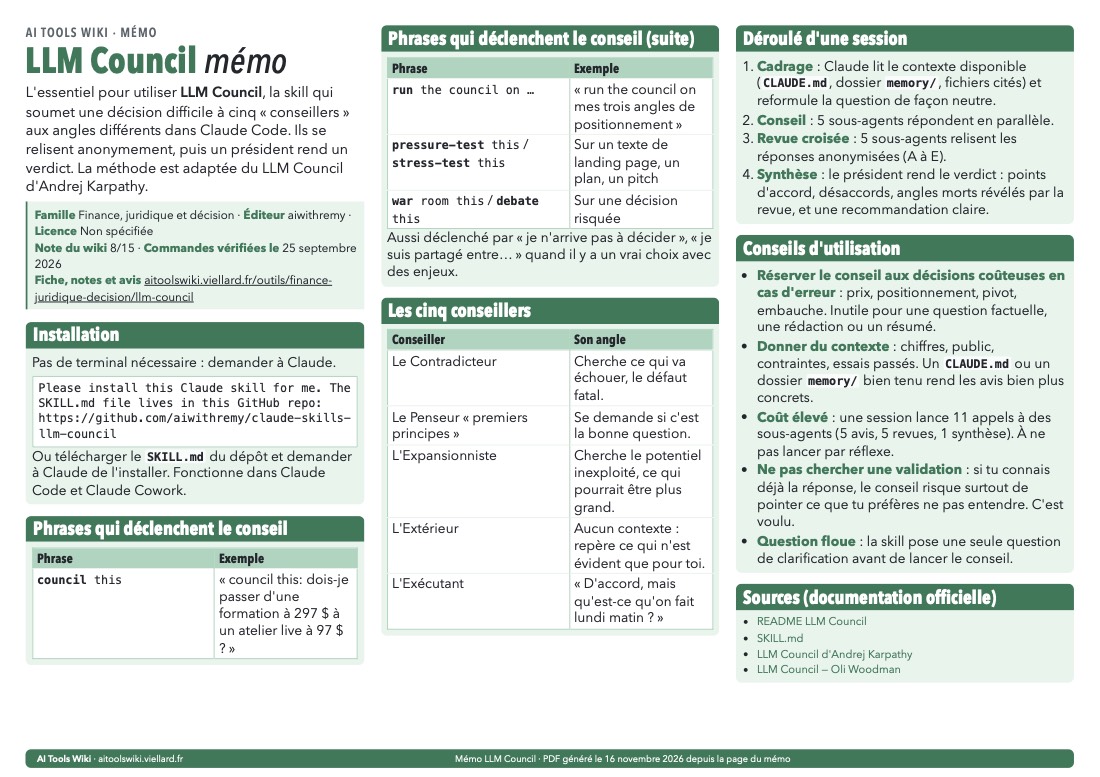
Télécharger le mémo en PDF (1 page A4 paysage, 157 Ko). Il est généré depuis la page du mémo, qui reste la version de référence : commandes à copier, recherche dans le site.
Avis indépendants
Synthèse des retours publiés, mise à jour le 24 septembre 2026.
Synthèse
L’idée de confronter plusieurs modèles est bien accueillie pour les décisions ambiguës, les revues de code et la recherche : des modèles différents peuvent révéler des angles morts, et une synthèse explicite est plus facile à auditer qu’une seule réponse. Des travaux sur le débat multi-agent montrent des gains possibles dans certains cadres.
Les praticiens soulignent néanmoins le coût, la latence et le risque de « consensus de modèles » fondé sur les mêmes données ou erreurs. Ajouter des voix n’apporte rien si les prompts, outils et sources sont identiques. Le choix du juge et l’ordre des revues influencent fortement le résultat ; une étude Claude/Codex observe même une asymétrie selon le modèle qui révise l’autre.
Comparaison
Un simple second avis manuel est moins coûteux. Les plugins de council automatisés avec hooks conviennent aux revues répétées ; les skills-only comme LLM Council restent plus transparentes et contrôlables. Les outils d’évaluation formelle sont préférables lorsque des réponses de référence existent.
Verdict
Pertinent pour les décisions importantes et incertaines ; excessif pour les tâches routinières. Diversifier modèles, données et rôles, puis garder un humain responsable de l’arbitrage.
Sources
Sources des avis
- Comparaison de huit plugins « council »
- Étude de revue croisée entre modèles
- Travaux sur le débat multi-agent
Dernière analyse : 12 novembre 2026